במאמר הזה
פעם בשבוע, קצר, בעברית: כלי שבדקתי, סוכן שבניתי, או טעות שעשיתי כדי שאתם לא תעשו אותה.
בקצרה: Alibaba השיקה את Qwen4-Max, והכותרות אומרות שהוא עוקף את Claude בקוד. בטבלה הרשמית של החברה הוא מוביל בבדיקת קוד אחת בהפרש קטן, ומפסיד ל-Opus 5.5 בשלוש אחרות. המודל סגור, והמספרים של החברה עצמה. לפני שמחליפים מודל, בודקים אותו על הקוד שלכם.
הבוקר ראיתי את הכותרת בכמה מקומות: "מודל סיני עוקף את Claude בקוד". זה סיפור שתמיד מושך, ומי שבונה עם Claude Code או עם Cursor שואל את עצמו מיד אם הוא משלם יותר מדי על המודל הלא נכון.
אז עשיתי מה שאני עושה עם כל השקה כזו: פתחתי את הבלוג הרשמי והלכתי ישר לטבלה. התמונה שם הרבה פחות חד משמעית מהכותרת.
מה Alibaba בעצם השיקה?
Qwen4-Max הוא מודל הדגל החדש של Alibaba. לפי הבלוג הרשמי יש בו 2.4 טריליון פרמטרים, מתוכם 71 מיליארד פעילים בכל טוקן, ראייה מובנית וחלון הקשר של מיליון טוקנים. הוא זמין בענן של Qwen ובכלים של החברה.
דבר אחד חשוב לדעת מההתחלה: המודל סגור. בבלוג Alibaba כותבת שהמודלים הקטנים במשפחה יעלו לקוד פתוח. על Max עצמו אין הבטחה כזו, ואי אפשר להוריד אותו ולהריץ אצלכם.
מה כתוב בטבלה הרשמית?
הדבר הראשון ששמתי לב אליו: בטבלה של Alibaba לא מופיע Claude Fable 5.1 בכלל. ההשוואה היא מול Opus 5.5, שני מודלים של OpenAI ו-Kimi K3.1. הכותרת על Fable 5.1 הגיעה מהסיקור בתקשורת, ולפי DEV Community היא מבוססת על תוצאות של Alibaba עצמה.
ואלה ארבע בדיקות הקוד מהטבלה:
| בדיקה | Qwen4-Max | Opus 5.5 | Kimi K3.1 |
|---|---|---|---|
| DeepSWE (קוד סוכני) | 75.7 | 74.2 | 75.5 |
| CodeArena (פיתוח ווב) | 1750 | 1816 | 1686 |
| Terminal-Bench 4.0 | 48.5 | 59.6 | 67.2 |
| ProgramBench | 31.5 | 65.0 | 25.0 |
מקור: הגרף בבלוג הרשמי של Qwen, נבדק ב-16.11.2026.
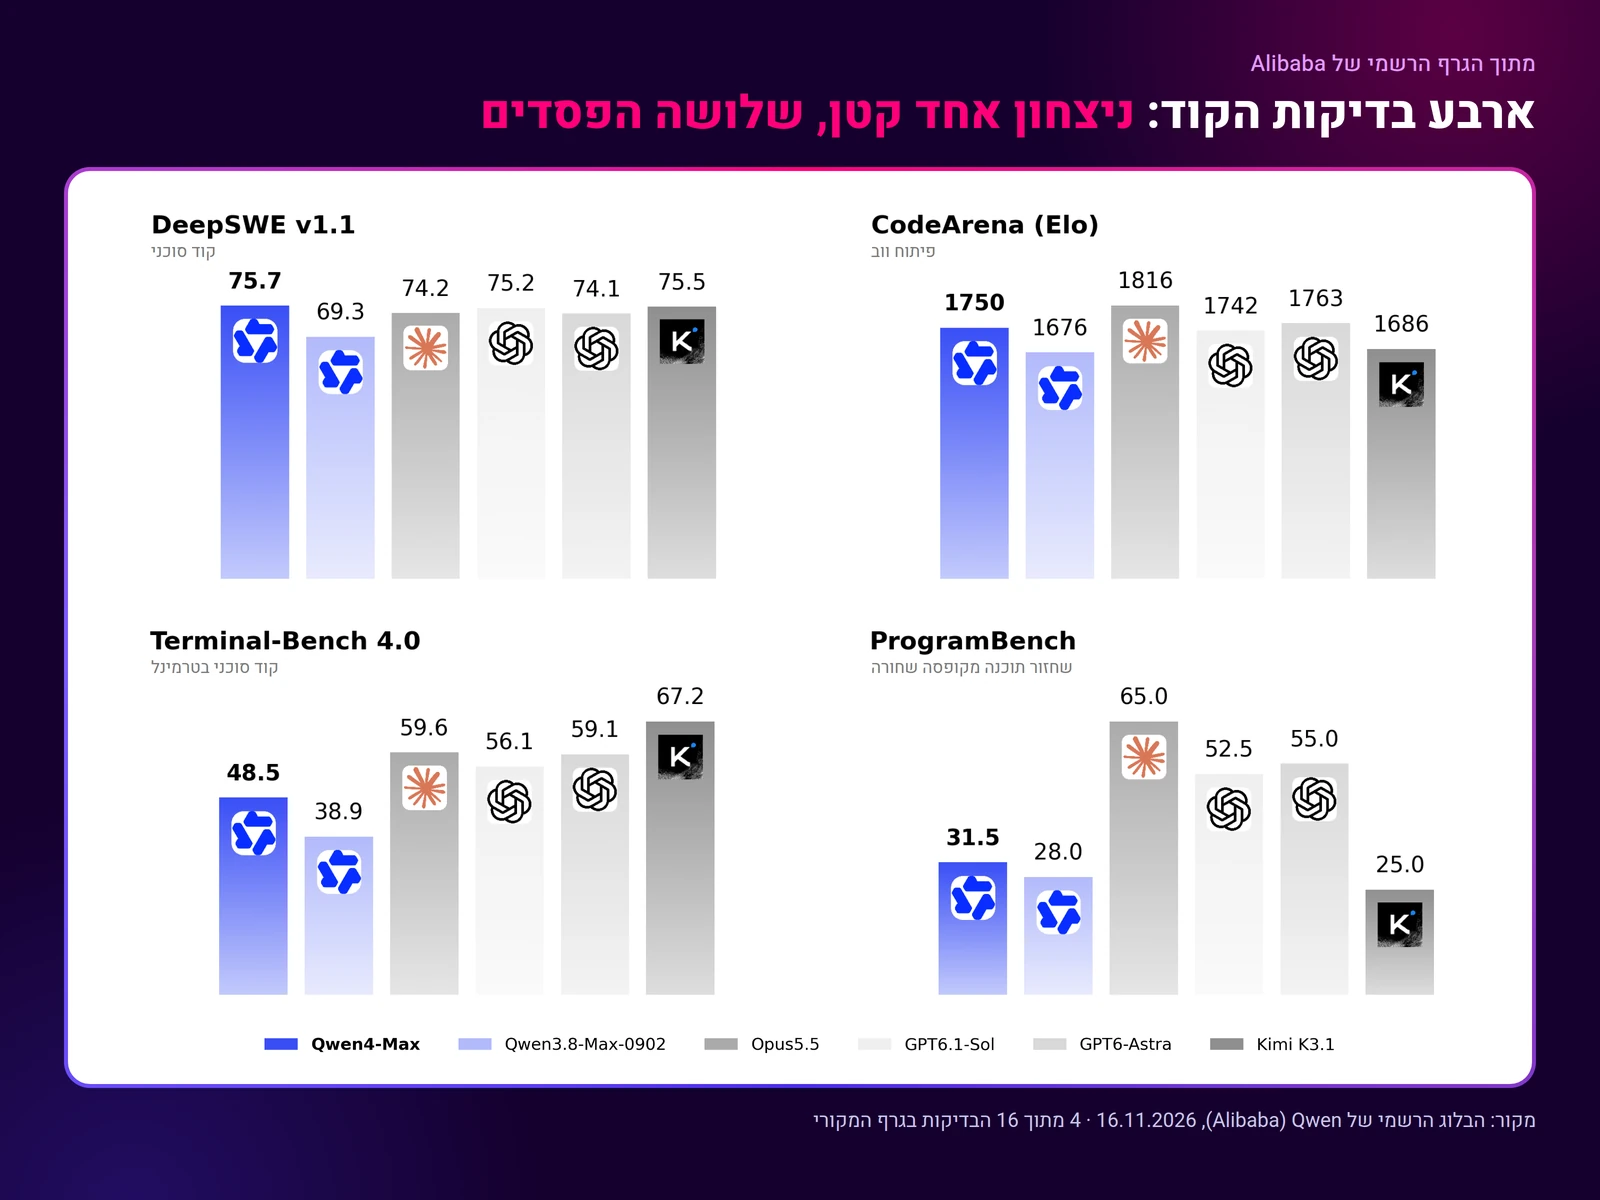
במילים פשוטות: ב-DeepSWE הוא מוביל ב-1.5 נקודות. ב-Terminal-Bench, שבודק עבודה בטרמינל, הוא אחרון מבין השלושה. ב-ProgramBench הוא מקבל פחות מחצי מהציון של Opus. ניצחון קטן אחד ושלושה הפסדים הם לא "עקף את Claude".
ומה אומרים מבחוץ?
בבדיקה עיוורת של קוד פרונט ב-CodeArena הוא במקום השישי, לפי BiGGo. דירוג נוסף שפורסם ב-DEV, מ-AgentArena, שם אותו במקום ה-14, הרבה אחרי Claude Fable 5.1. זה מקור יחיד ונמדד לפני ההשקה הסופית, אז אני מתייחס אליו כאל דיווח ולא כאל עובדה.
אז איפה הוא כן מעניין?
להוגנות, יש פה דברים אמיתיים. ב-Agents' Last Exam הוא מוביל עם 46.7 מול 43.4. ולפי Alibaba, העלות הממוצעת למשימה בבדיקה שלהם ירדה מ-4.43$ ל-1.67$ לעומת הגרסה הקודמת שלהם, בעיקר כי הוא משתמש בהרבה פחות טוקנים.
זה הכיוון שמעניין אותי יותר מהכותרת: מודלים שעושים עבודה דומה בפחות טוקנים. התחרות הזו טובה לכולנו, כי היא לוחצת על המחירים של כולם.
ובכל זאת, נתון אחד מהבלוג שלהם כדאי לזכור: בבדיקת קוד מאובטח, שיעור המעבר עלה מ-22.0% ל-31.8%. שיפור יפה, אבל זה עדיין אומר שרוב הקוד לא עבר את הבדיקה. את זה לא פותרים בהחלפת מודל, אלא בבדיקה שלכם.
למה אני לא מחליף מודל לפי כותרת
כל חברה בוחרת אילו בדיקות להציג ומול מי להשוות. זה לגיטימי, זה שיווק. אבל בנצ'מרק מודד משימות כלליות, לרוב באנגלית, ולא את הקוד שלכם, את הספריות שלכם ואת הממשק בעברית.
יש גם כמה אותיות קטנות. לפי סקירה של eesel, בתקופת ה-preview הגישה היא רק דרך מנוי Token Plan, רק לשימוש אינטראקטיבי בכלי קוד, ובלי סקריפטים אוטומטיים. אלה תנאי ה-preview, ועוד לא ברור מה יהיו התנאים אחריו. ומודל סגור אומר שאתם תלויים בספק אחד, בלי אפשרות להריץ אותו אצלכם.
כל שבוע אני עובר על ההשקות של השבוע ומפריד בין מה שעובד לבין מה שרק נשמע טוב. הצטרפו לגיליון "אלעד עמרני AI", פעם בשבוע במייל.
איך אני הייתי בודק אותו על הקוד שלכם
אם המחיר והחיסכון בטוקנים מעניינים אתכם, תבדקו בעצמכם. זה לוקח פחות זמן ממה שנדמה:
- בחרו 5 משימות אמיתיות מהפרויקט שלכם: באג אחד, פיצ'ר קטן, ריפקטור, משהו בטרמינל, ומסך אחד עם טקסט בעברית.
- הריצו את אותן משימות על המודל שאתם עובדים איתו היום ועל Qwen4-Max, עם אותן הוראות.
- תנו ציון בעצמכם: האם הקוד רץ, האם הייתם מעלים אותו כמו שהוא, וכמה תיקונים הוא דרש.
- בדקו את העברית בנפרד: כיוון מימין לשמאל, טקסטים בממשק, ותשובות להוראות שכתבתם בעברית. כאן מודלים נבדלים מאוד, ואף טבלה לא מודדת את זה.
- ספרו כמה זה עלה לכל משימה שהסתיימה נכון, ולא רק לפי מחיר לטוקן.
מה אני הייתי עושה
לא הייתי מחליף שום דבר היום. הייתי שומר את חמש המשימות האלה כסט בדיקה קבוע, ומריץ עליו כל מודל חדש שיוצא. ככה, בפעם הבאה שתופיע כותרת על מודל ש"עוקף את כולם", תדעו תוך שעה אם זה נכון אצלכם.
הריפו שלכם הוא הבנצ'מרק היחיד שבאמת משנה.
שאלות נפוצות
האם Qwen4-Max באמת טוב יותר מ-Claude בקוד?
לפי הטבלה הרשמית של Alibaba, הוא מוביל בבדיקת קוד אחת (DeepSWE) בהפרש של 1.5 נקודות, ומפסיד ל-Opus 5.5 ב-Terminal-Bench, ב-CodeArena וב-ProgramBench. אין עדיין בדיקה עצמאית מלאה, ולכן התשובה תלויה בקוד שלכם.
האם Qwen4-Max בקוד פתוח?
לא. בבלוג הרשמי Alibaba כותבת שהמודלים הקטנים במשפחת Qwen4 יעלו לקוד פתוח. על Max עצמו אין הבטחה כזו, ואי אפשר להוריד אותו ולהריץ אצלכם.
אפשר לחבר את Qwen4-Max ל-Claude Code או ל-Cursor?
לפי סקירה של eesel, בתקופת ה-preview אפשר לחבר אותו לכלי קוד כמו Claude Code, Cursor, Cline ו-Codex, דרך מנוי Token Plan ורק לשימוש אינטראקטיבי. התנאים אחרי ה-preview עוד לא ברורים.
למה לא לסמוך על בנצ'מרקים?
כי כל חברה בוחרת אילו בדיקות להציג ומול מי. בנצ'מרק מודד משימות כלליות, לרוב באנגלית. הקוד שלכם, הספריות שלכם והעברית שלכם נבדקים רק כשמריצים עליהם.
רוצים לקבל כל שבוע את ההשקות החשובות, עם מה שבאמת כדאי לבדוק? הצטרפו לגיליון "אלעד עמרני AI". ואם אתם רוצים סדנה לצוות, או סוכן AI שמתאים לעסק שלכם, דברו איתנו.
הנתונים מתוך הבלוג הרשמי של Qwen, ומהסיקור ב-DEV Community, eesel ו-Bloomberg.
בונה סוכני AI לעסקים ב-Agentic-dev, החברה שלי, ומלמד צוותים לעבוד עם AI וסוכנים, בסדנאות ובהרצאות.