Gemma 4 12B מביא מולטימודליות חזקה למחשב האישי
לפעמים ההבדל בין רעיון טוב למוצר אמיתי הוא לא היכולת של המודל. הוא פשוט המקום שבו הוא רץ.
זה בדיוק מה שעושה את Gemma 4 12B מעניין כל כך. הוא מביא יכולות מולטימודליות וסוכן מתקדמות ישירות ללפטופ ולסביבות מקומיות, בלי להכביד יותר מדי על המערכת.
למה Gemma 4 12B תפס את תשומת הלב של מפתחים
אני רואה שוב ושוב את אותה סיטואציה. צוות בונה רעיון טוב, ואז נתקע בשכבת התשתית.
המודל כבד מדי. הלטנסי גבוה מדי. והניסוי נמרח. כאן Gemma 4 12B נכנס למקום מעניין מאוד, כי הוא מנסה לשים איזון בין יכולת לבין נגישות.
ארכיטקטורה שמפשטת את הצינור
אחד הדברים הבולטים כאן הוא מבנה מאוחד, בלי encoders נפרדים לראייה ולאודיו. במקום להעביר כל קלט דרך שכבת תרגום נפרדת, המודל מזרים אותו ישר אל ה־LLM backbone.
למה זה טוב לנו? כי זה חוסך מורכבות, מצמצם שימוש בזיכרון, ומקל על בניית מערכות נקיות יותר.
אודיו כבר לא נשאר מחוץ למשחק
Gemma 4 12B תומך גם בקלט אודיו טבעי. זאת אומרת, הוא לא רק מודל לטקסט ולתמונה.
המשמעות המעשית ברורה. אפשר לחשוב על סוכני קול, ניתוח שיחות, תיעוד פגישות, או עוזרים שמגיבים בזמן אמת. זה כבר בסיס הרבה יותר עשיר למוצרים אינטראקטיביים.
מה מיוחד ב Gemma 4 12B בפועל
החלק המעניין הוא לא רק מה המודל יודע לעשות. החלק המעניין הוא מה אפשר באמת לבנות איתו.
Gemma 4 12B יושב בנקודה טובה בין ביצועים, גמישות ונגישות. הוא לא קטן מדי, אבל גם לא כבד כמו מודלים גדולים יותר.
עיבוד ויזואלי פשוט ויעיל יותר
בצד הוויזואלי, המודל משתמש במודול הטמעה קל יותר במקום מקודד ראייה מלא. זה נשמע טכני, אבל התוצאה פשוטה מאוד.
פחות עומס. פחות זמן תגובה. יותר התאמה להרצה מקומית. עבור מי שבונה פרוטוטייפים מהירים, זה יכול להיות הבדל אמיתי.
אודיו שמתחבר ישירות למרחב הטקסט
גם בצד של האודיו נעשתה פישוטה. המודל ממפה את אות הקול למרחב הייצוג של הטקסט.
מה יוצא מזה? מערכת שנראית פחות מסורבלת, ומרגישה יותר זורמת. כשבונים מוצר, זה חשוב לא פחות מהדיוק עצמו.
Multi-Token Prediction מוריד השהיה
Gemma 4 12B כולל תמיכה ב־MTP, כלומר Multi-Token Prediction. בפועל, זה עוזר להאיץ את קצב התשובה ולהפחית latency.
בסוכני AI, אפילו חצי שנייה מורגשת. לכן כל שיפור קטן כאן מתורגם ישר לחוויה טובה יותר.
הסיפור האמיתי מאחורי הבחירה במודל כזה
אני ממש אוהב מודלים שמכבדים את המציאות. לא רק את הבנצ'מרק.
בשטח, רוב הצוותים לא צריכים מודל ענק. הם צריכים מודל שנכנס לתהליך העבודה שלהם, מגיב מהר, ונותן בסיס אמין לבנייה.
כשמודל לא נכנס לסביבה, הוא לא באמת זמין
זה נשמע פשוט, אבל זו תובנה חזקה. אם אי אפשר להריץ את המודל בנוחות, הוא נשאר רעיון יפה.
Gemma 4 12B מנסה לפתור בדיוק את הפער הזה. הוא מביא יכולת רצינית לסביבה נגישה יותר.
מתאים במיוחד לעולם של AI Agents
סוכן טוב צריך יותר מתשובה חכמה. הוא צריך להבין הקשר, לפעול עקבי, ולהגיב מהר.
כאן יש ערך אמיתי למודל מקומי. הוא נותן שליטה טובה יותר, מגיב מהר יותר, ומקל על בניית זרימות עבודה אמינות.
איך Gemma 4 12B משתלב בפרקטיקה
ברגע שמורידים את המודל לקרקע, הדברים מתחילים להסתדר יותר טוב. אפשר לבחון רעיונות בלי להקים תשתית כבדה.
אפשר לבנות אוטומציות. אפשר להריץ ניסויים. אפשר לבדוק חוויות משתמש חדשות בלי להיתקע בשרשרת ארוכה של תלות חיצונית.
שימושים שמתאימים במיוחד
- סוכני AI מקומיים עם תגובה מהירה.
- כלי ניתוח למסמכים, תמונות וקול באותו צינור עבודה.
- אוטומציות חכמות ב־n8n, Make וסביבות דומות.
- פרוטוטייפים ל־Vibe Coding עם חוויית פיתוח קלה יותר.
- פתרונות ארגוניים שדורשים יותר שליטה בפרטיות ובעלות התשתית.
למה זה חשוב לצוותים
כי צוותים טובים לא נמדדים רק ברעיון. הם נמדדים במהירות ההוצאה לפועל.
Gemma 4 12B נותן בסיס נוח יותר לניסוי, וזה חוסך זמן יקר בתחילת הדרך.
איך להתחיל לעבוד עם Gemma 4 12B
היתרון של Gemma 4 12B הוא שגם קל להתחיל איתו. לא צריך לבנות הכול מאפס.
אפשר לבדוק אותו בכלים כמו LM Studio, Ollama, Google AI Edge Gallery App ו־LiteRT-LM CLI. בנוסף, אפשר להוריד משקולות מ־Hugging Face ומ־Kaggle ולהתחיל מהר.
כלי פיתוח וסביבות אינטגרציה
למי שרוצה להעמיק, יש תמיכה גם ב־Hugging Face Transformers, llama.cpp, MLX, SGLang ו־vLLM. אפשר גם לכוונן אותו עם Unsloth.
זה חשוב כי אין כאן נעילה לכלי אחד. אפשר לבחור את הסביבה שמתאימה לפרויקט, לחומרה ולצורת העבודה של הצוות.
פריסה בענן כשצריך
למרות שהערך הגדול הוא בהרצה מקומית, אפשר גם לפרוס בענן. יש מסלול ל־Google Cloud דרך Model Garden, Cloud Run ו־GKE.
זאת אומרת, אפשר להתחיל קטן, לבדוק מהר, ואז להתרחב אם הפרויקט באמת מצדיק את זה.
Gemma Skills והכיוון של סוכנים
אחד החלקים המעניינים בהשקה הוא מאגר ה־Skills הרשמי. זה סט כלים שמכוון לעזור לסוכנים לעבוד טוב יותר עם היכולות החדשות של המודל.
כאן רואים משהו חשוב. לא מספיק שיהיה מודל טוב. צריך גם לדעת לבנות סביבו סוכן טוב.
סוכן טוב לא נמדד רק בתשובה שלו
אני חשוב, אבל עדיין, מה שבאמת קובע הוא היכולת לפעול לאורך זמן. עקביות חשובה יותר מניסוח יפה.
לכן Gemma 4 12B מעניין במיוחד למי שבונה מערכות עם לוגיקה, שלבים והחלטות.
חיבור טבעי ל־Vibe Coding
כשעובדים בגישת Vibe Coding, מחפשים דרך לבנות מהר בלי לאבד שליטה.
מודל מקומי טוב נותן בדיוק את השילוב הזה. הוא עוזר לזרז בנייה, לבדוק כיוונים, ולשמור על תהליך פיתוח נוח יותר.
Gemma 4 12B מול הצרכים של היום
השוק זז לכיוון ברור. יש יותר צורך בפרטיות. יש יותר רצון לשליטה. ויש יותר ערך למערכות מקומיות.
Gemma 4 12B עונה על כל זה בצורה די מדויקת, במיוחד עבור מפתחים וארגונים שרוצים פתרון פרקטי.
האיזון הוא הנקודה המרכזית
המודל לא מנסה להיות הכי גדול. הוא מנסה להיות שימושי.
ובמקום כמו AI Agents, זה הרבה יותר חשוב. כי אם אי אפשר להפעיל את המודל בפועל, הוא לא עוזר באמת.
למי זה מתאים במיוחד
המודל מתאים למפתחים עצמאיים, לצוותי מוצר, ולארגונים שרוצים להוריד תלות בענן.
הוא מתאים גם למי שמחפש סביבת עבודה טובה יותר לניסוי, ללמידה ולבניית מוצרים חכמים.
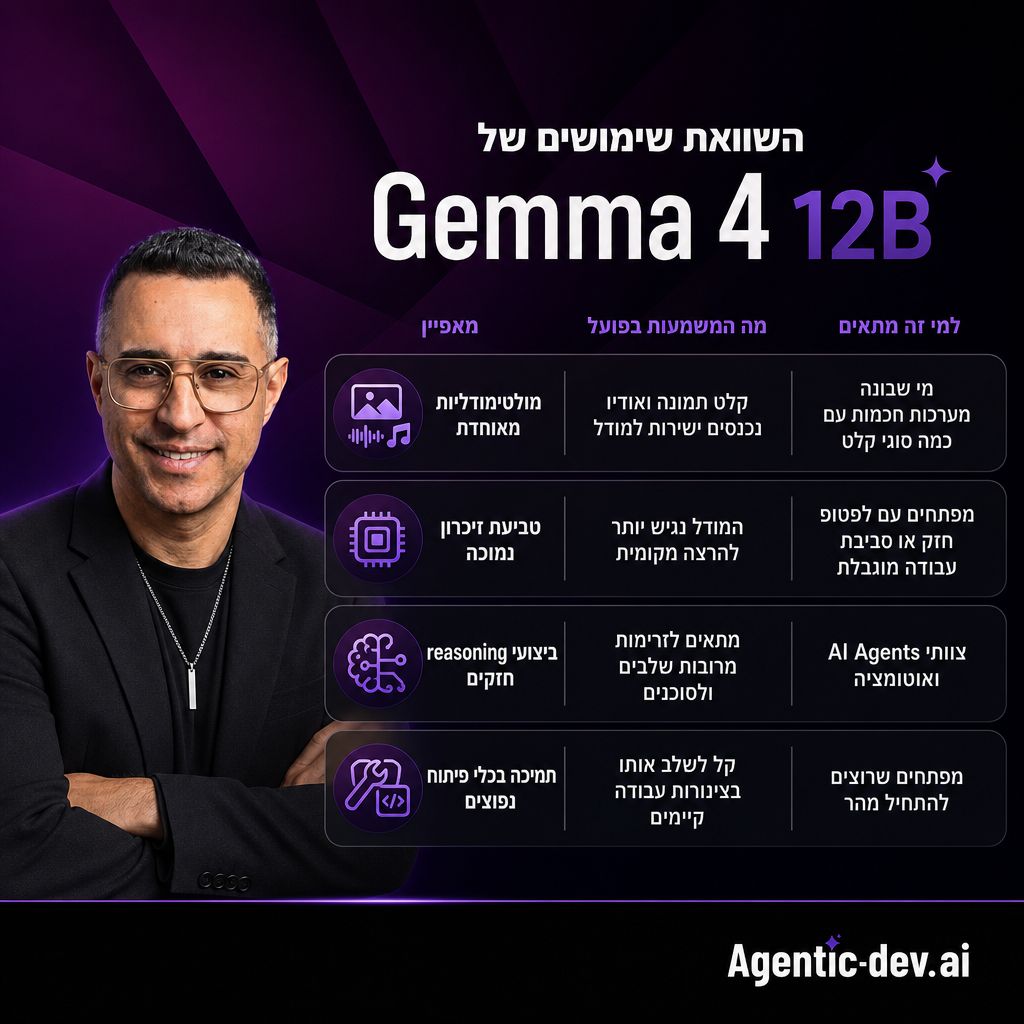
השוואת שימושים של Gemma 4 12B
| מאפיין | מה המשמעות בפועל | למי זה מתאים |
|---|---|---|
| מולטימודליות מאוחדת | קלט תמונה ואודיו נכנסים ישירות למודל | מי שבונה מערכות חכמות עם כמה סוגי קלט |
| טביעת זיכרון נמוכה | המודל נגיש יותר להרצה מקומית | מפתחים עם לפטופ חזק או סביבת עבודה מוגבלת |
| ביצועי reasoning חזקים | מתאים לזרימות מרובות שלבים ולסוכנים | צוותי AI Agents ואוטומציה |
| תמיכה בכלי פיתוח נפוצים | קל לשלב אותו בצינורות עבודה קיימים | מפתחים שרוצים להתחיל מהר |
מי שרוצה להעמיק גם בהקשר הטכנולוגי הרחב יכול להסתכל על התיעוד של Hugging Face Transformers, וגם על המסלול של llama.cpp להרצה מקומית. אלו מקורות טובים להבין איך מודלים כאלה משתלבים בפועל.
אם בא לכם לראות את הכיוון של פריסת ענן, אפשר גם להיכנס ל־Vertex AI של Google Cloud ולהבין איך מחברים את זה לתהליכי עבודה רחבים יותר.
FAQ על Gemma 4 12B
האם Gemma 4 12B באמת מתאים להרצה מקומית?
כן, בתנאים הנכונים. לפי ההשקה, המודל קטן מספיק כדי לרוץ מקומית על מחשבים עם 16GB VRAM או זיכרון מאוחד.
זה לא אומר שכל מכונה תרגיש אותו הדבר, אבל זה בהחלט מציב אותו בקטגוריה נגישה יותר ממודלים כבדים במיוחד. עבור מפתחים, זו נקודת פתיחה נוחה מאוד.
מה היתרון של Gemma 4 12B מול מודלים אחרים?
היתרון המרכזי הוא האיזון. Gemma 4 12B מציע מולטימודליות, reasoning מתקדם וארכיטקטורה יעילה יותר.
הוא לא מנסה להיות הכי גדול בכל מחיר. הוא מנסה להיות מודל שאפשר לעבוד איתו באמת, וזה שיקול חשוב מאוד.
למה ה־encoder-free architecture חשובה?
כי היא מפחיתה מורכבות. כשאין רכיבי עיבוד נפרדים לתמונה ולאודיו, המערכת חוסכת זמן וזיכרון.
בנוסף, זה מייעל את כל הזרימה של הנתונים בתוך המודל. למוצר בפועל, זה מתורגם לפחות השהיה וליותר יציבות.
איך כדאי להתחיל עם Gemma 4 12B בפועל?
הכי נכון להתחיל מניסוי קצר בסביבה מוכרת. אפשר לבדוק ב־LM Studio או Ollama, ואז לעבור לסביבת פיתוח מתאימה יותר כמו Hugging Face או llama.cpp.
אם הפרויקט מתקדם, אפשר לחבר אותו לאוטומציה או לכוונון קל. ההמלצה שלי היא להתחיל קטן וברור.
סיכום
Gemma 4 12B הוא לא עוד מודל ביניים. הוא ניסיון רציני להביא מולטימודליות, reasoning ויכולות סוכן לסביבת עבודה נגישה יותר.
בשורה התחתונה, הוא מעניין כי הוא פרקטי. הוא מתאים למי שבונה AI Agents, למי שעובד עם Vibe Coding, ולמי שרוצה להריץ יותר בינה מלאכותית מקומית בלי לוותר על איכות.
אם אתם בונים היום מערכות AI אמיתיות, שווה לבדוק אותו ברצינות. לפעמים דווקא המודל שנכנס נכון לסביבת העבודה הוא זה שמתקדם הכי רחוק.
ואתם, הייתם בוחרים להתחיל עם מודל מקומי ונגיש, או להישאר רק בענן?
