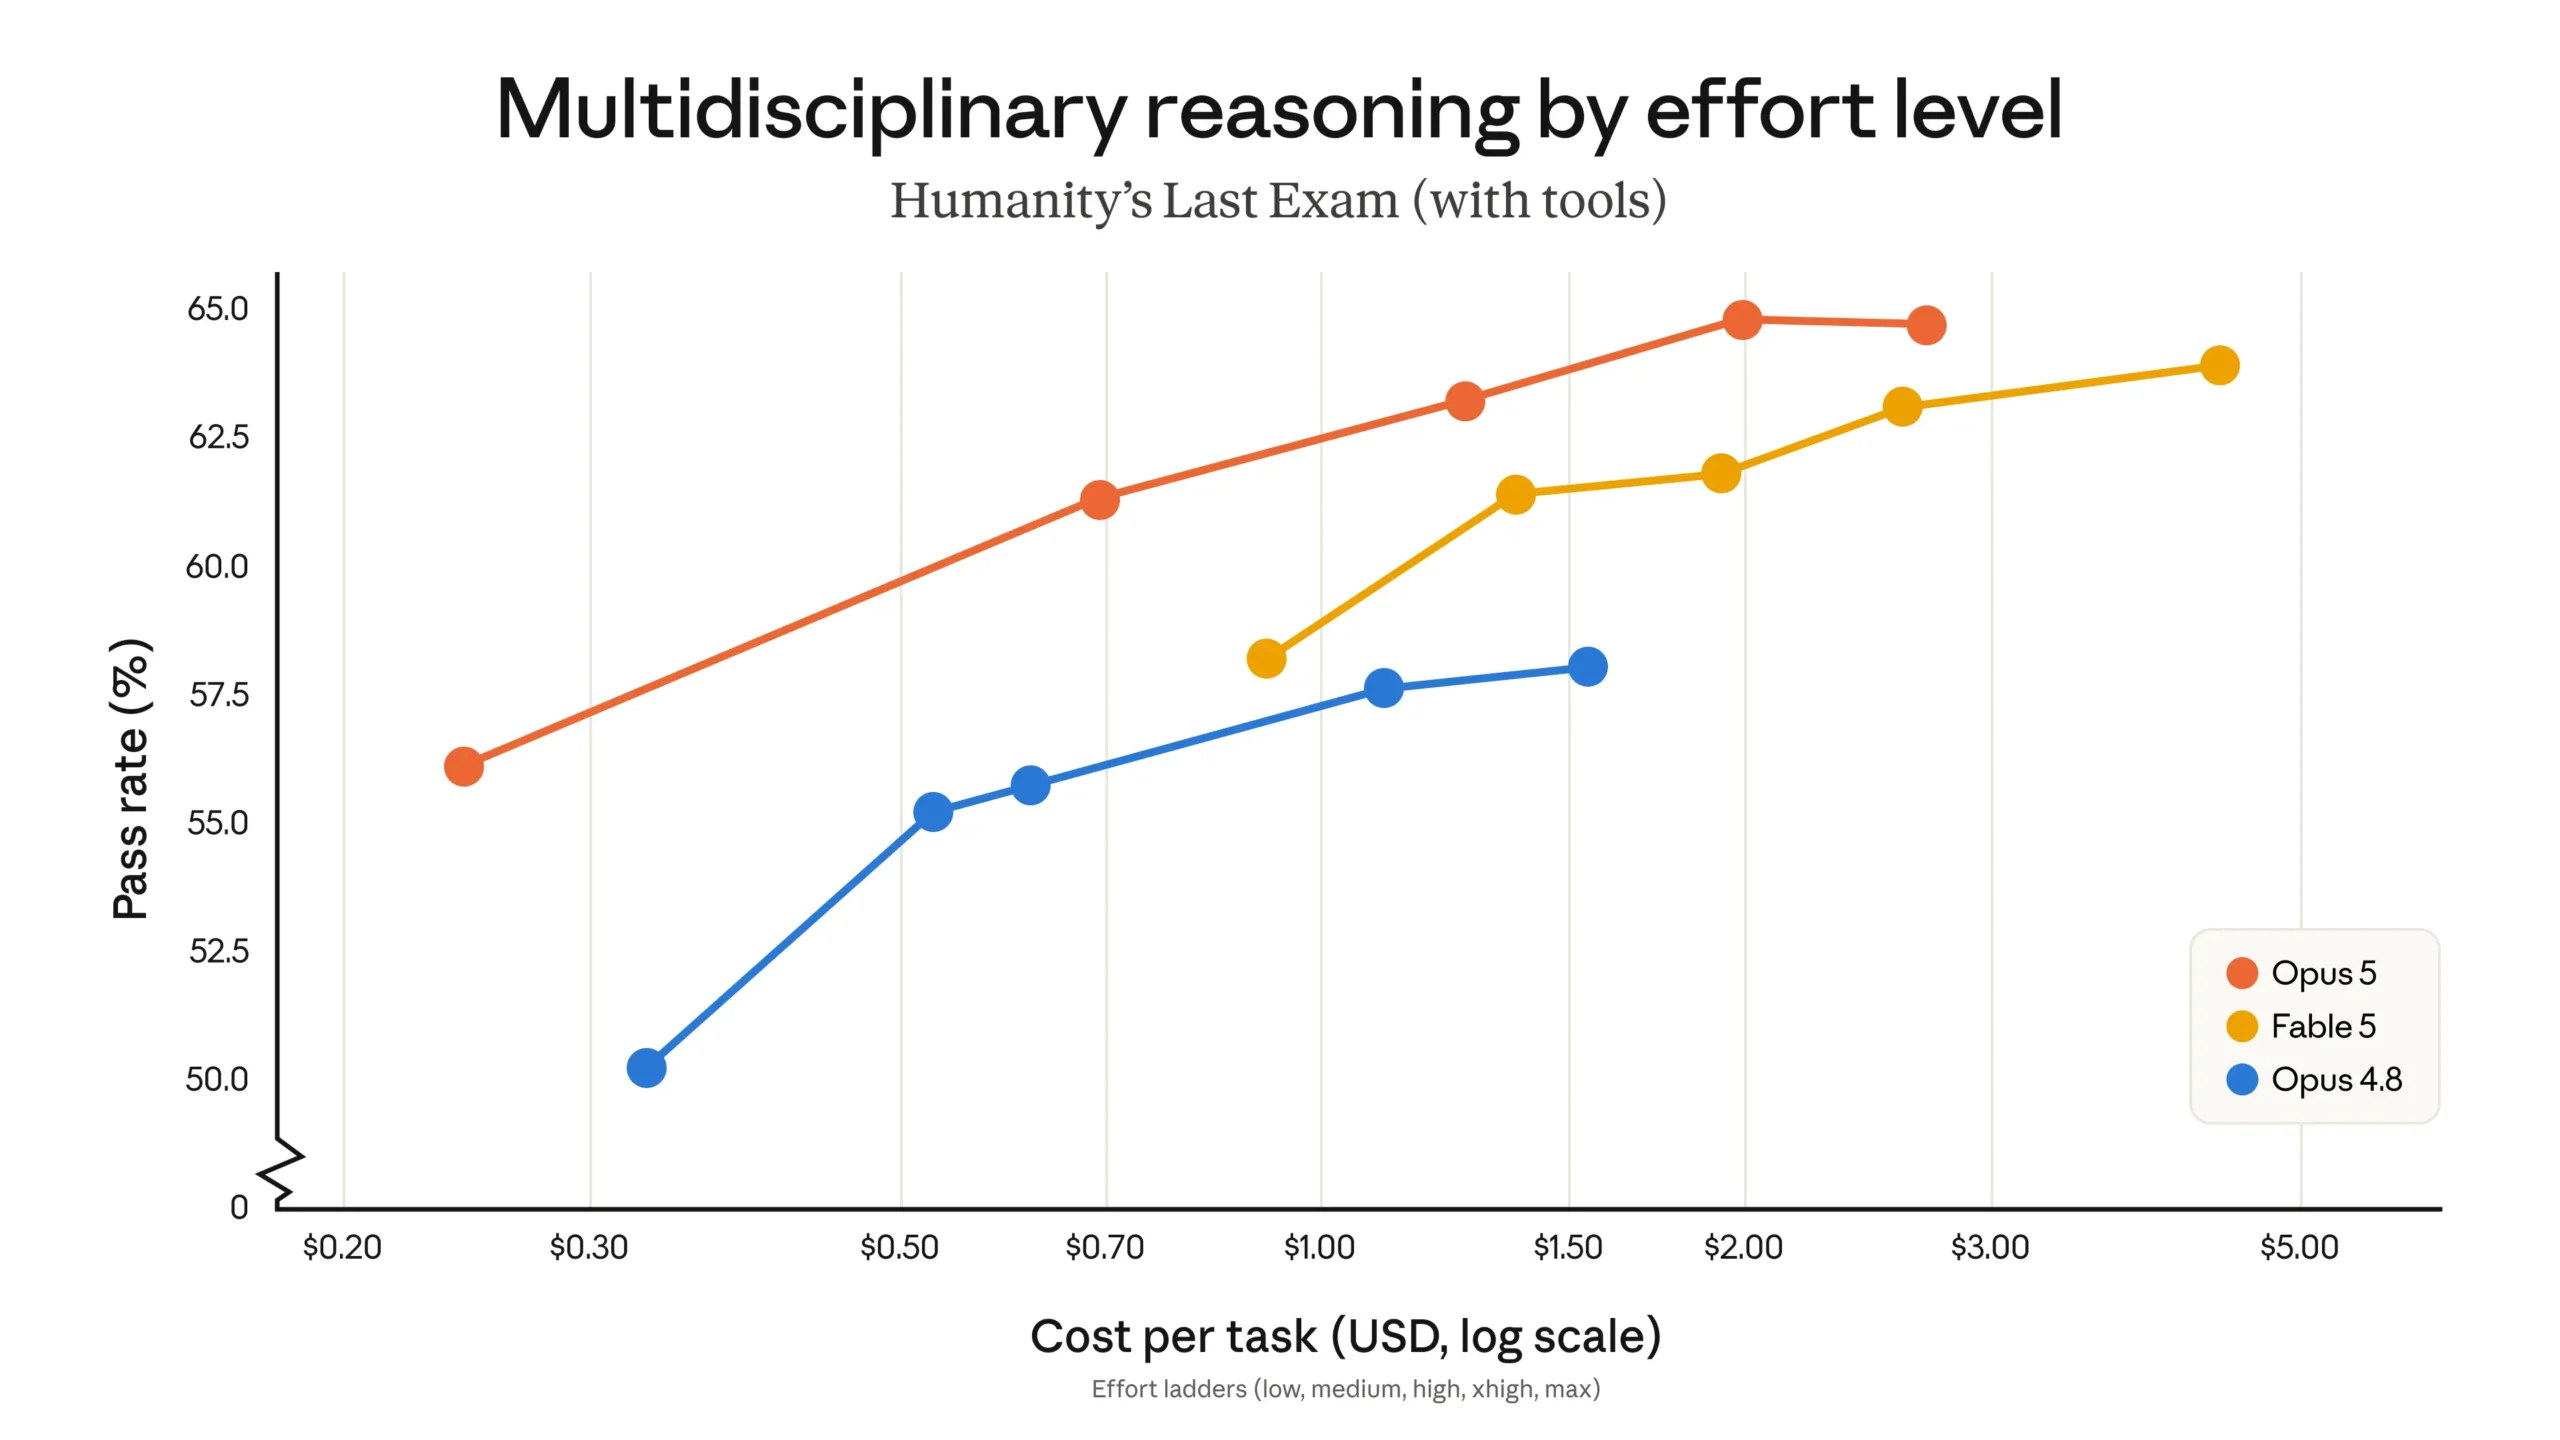
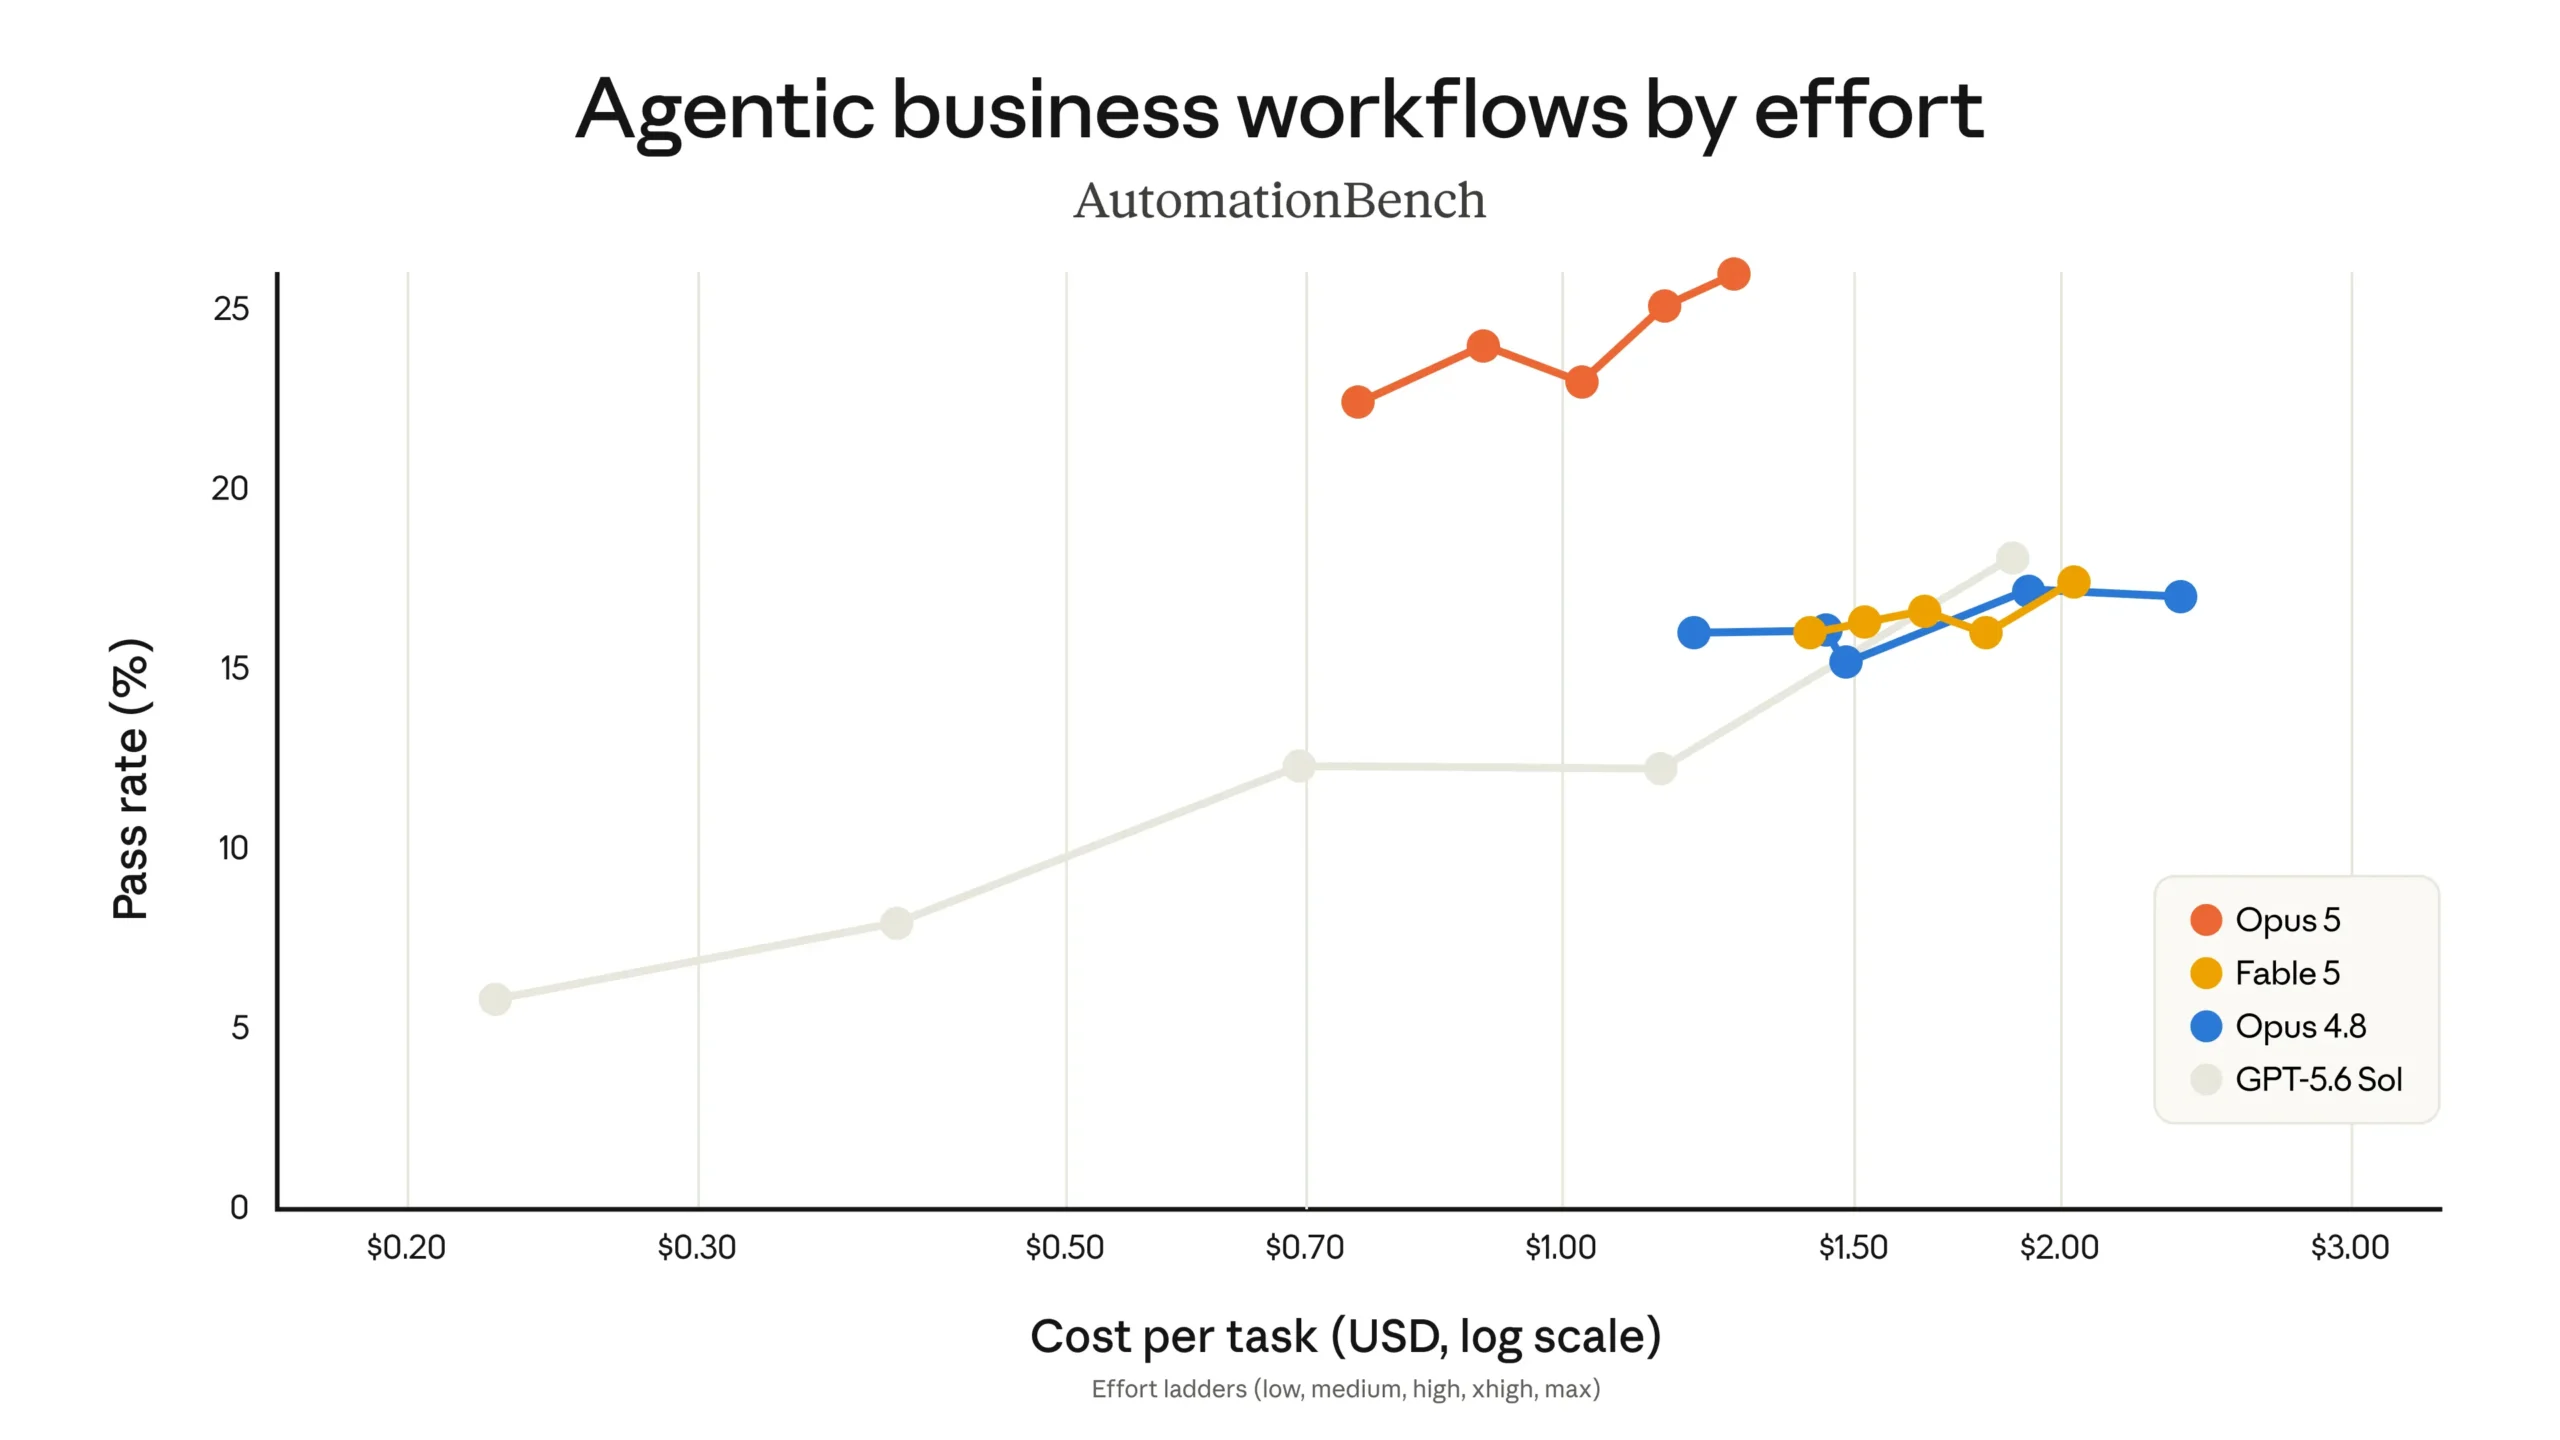
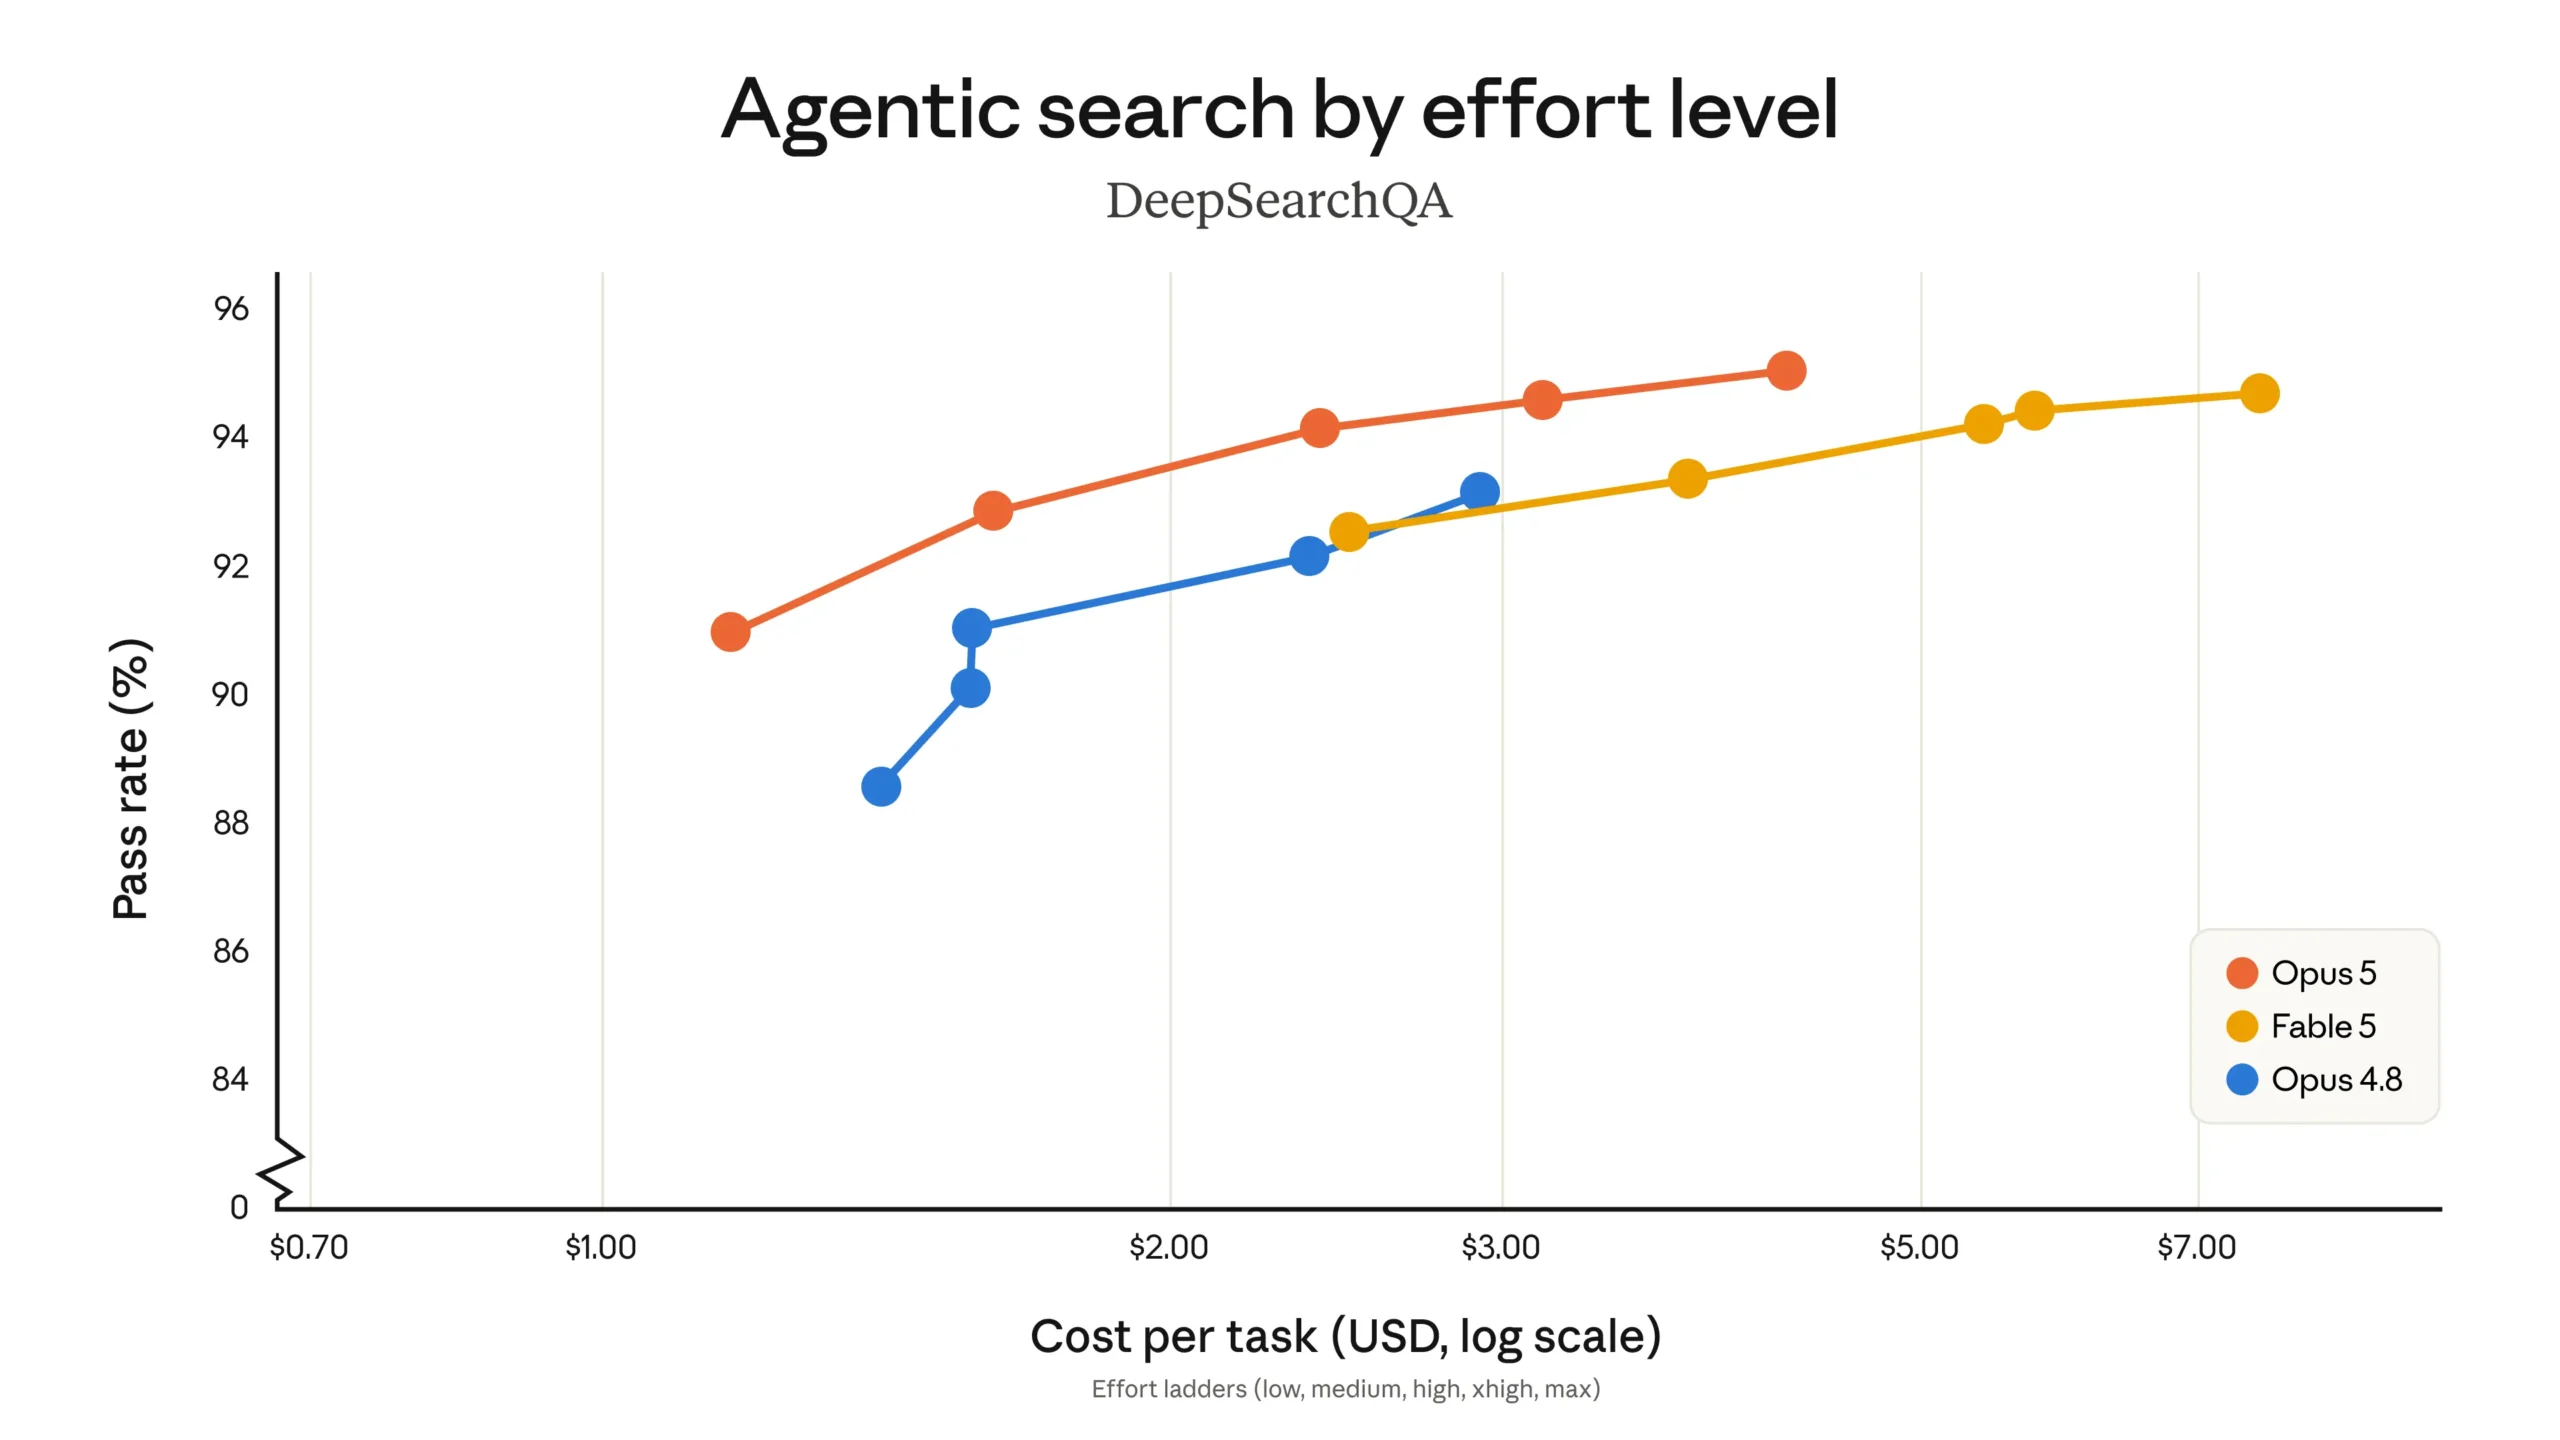
claude opus 5: ביצועים מתקדמים בעלות נמוכה יותר למשימה
claude opus 5 הוא מודל מתקדם של Anthropic, שמציג כיוון חשוב בעולם הבינה המלאכותית: לא רק ביצועים גבוהים, אלא גם עלות יעילה יותר להשלמת עבודה שלמה.
ההבדל הזה משמעותי. מודל יכול להיות זול לשימוש, אך לדרוש תיקונים רבים, הפעלות חוזרות וזמן עבודה אנושי. לכן המדד החשוב באמת הוא לא רק מחיר הטוקנים, אלא עלות המשימה המלאה.
זאת אומרת, השאלה העסקית היא פשוטה: איזה מודל מספק תוצאה אמינה, בזמן סביר ובעלות שמתאימה לתהליך אמיתי? claude-opus-5 מנסה לתת תשובה טובה לשאלה הזאת.
למה claude opus 5 מעניין עסקים וארגונים?
לפי החומר שסופק, Anthropic מציגה את claude-opus-5 כמודל שמתקרב בביצועיו למודל הדגל Fable 5. לפי החברה, המודל זמין החל מ-24 ביולי 2026 ומכוון לעבודה בקוד, אוטומציה, מחקר, ניתוח נתונים ושימוש במחשב.
מחיר הבסיס שפורסם נשאר זהה למחיר של Opus 4.8: 5 דולר למיליון טוקנים בקלט ו-25 דולר למיליון טוקנים בפלט. היתרון הנטען מגיע מהיכולת להשלים יותר עבודה באותה עלות.
אבל למה זה טוב לנו? בעבודה ארוכה, המודל לא רק מקבל שאלה ומחזיר תשובה. הוא עשוי לקרוא מידע, להפעיל כלים, לבדוק תוצאה, לזהות טעות ולנסות שוב. כאשר הוא מצליח לעשות זאת בפחות סבבים, העלות הכוללת עשויה לרדת.
הערך נמצא בתוצאה הסופית
מבחן ביצועים בודד אינו מספר את כל הסיפור. עסק צריך לבדוק אם המודל השלים את המשימה, ולא רק אם הוא קיבל ציון גבוה.
לדוגמה, סוכן שמנתח מסמכים יכול להחזיר תשובה מהירה. אם אדם צריך לבדוק כל משפט ולתקן שגיאות, החיסכון כמעט נעלם. לעומת זאת, מודל שמסביר את התהליך, בודק את עצמו ומחזיר תוצאה שימושית עשוי לייצר ערך גבוה יותר.
היכולות המרכזיות של claude opus 5
פיתוח תוכנה ופתרון תקלות
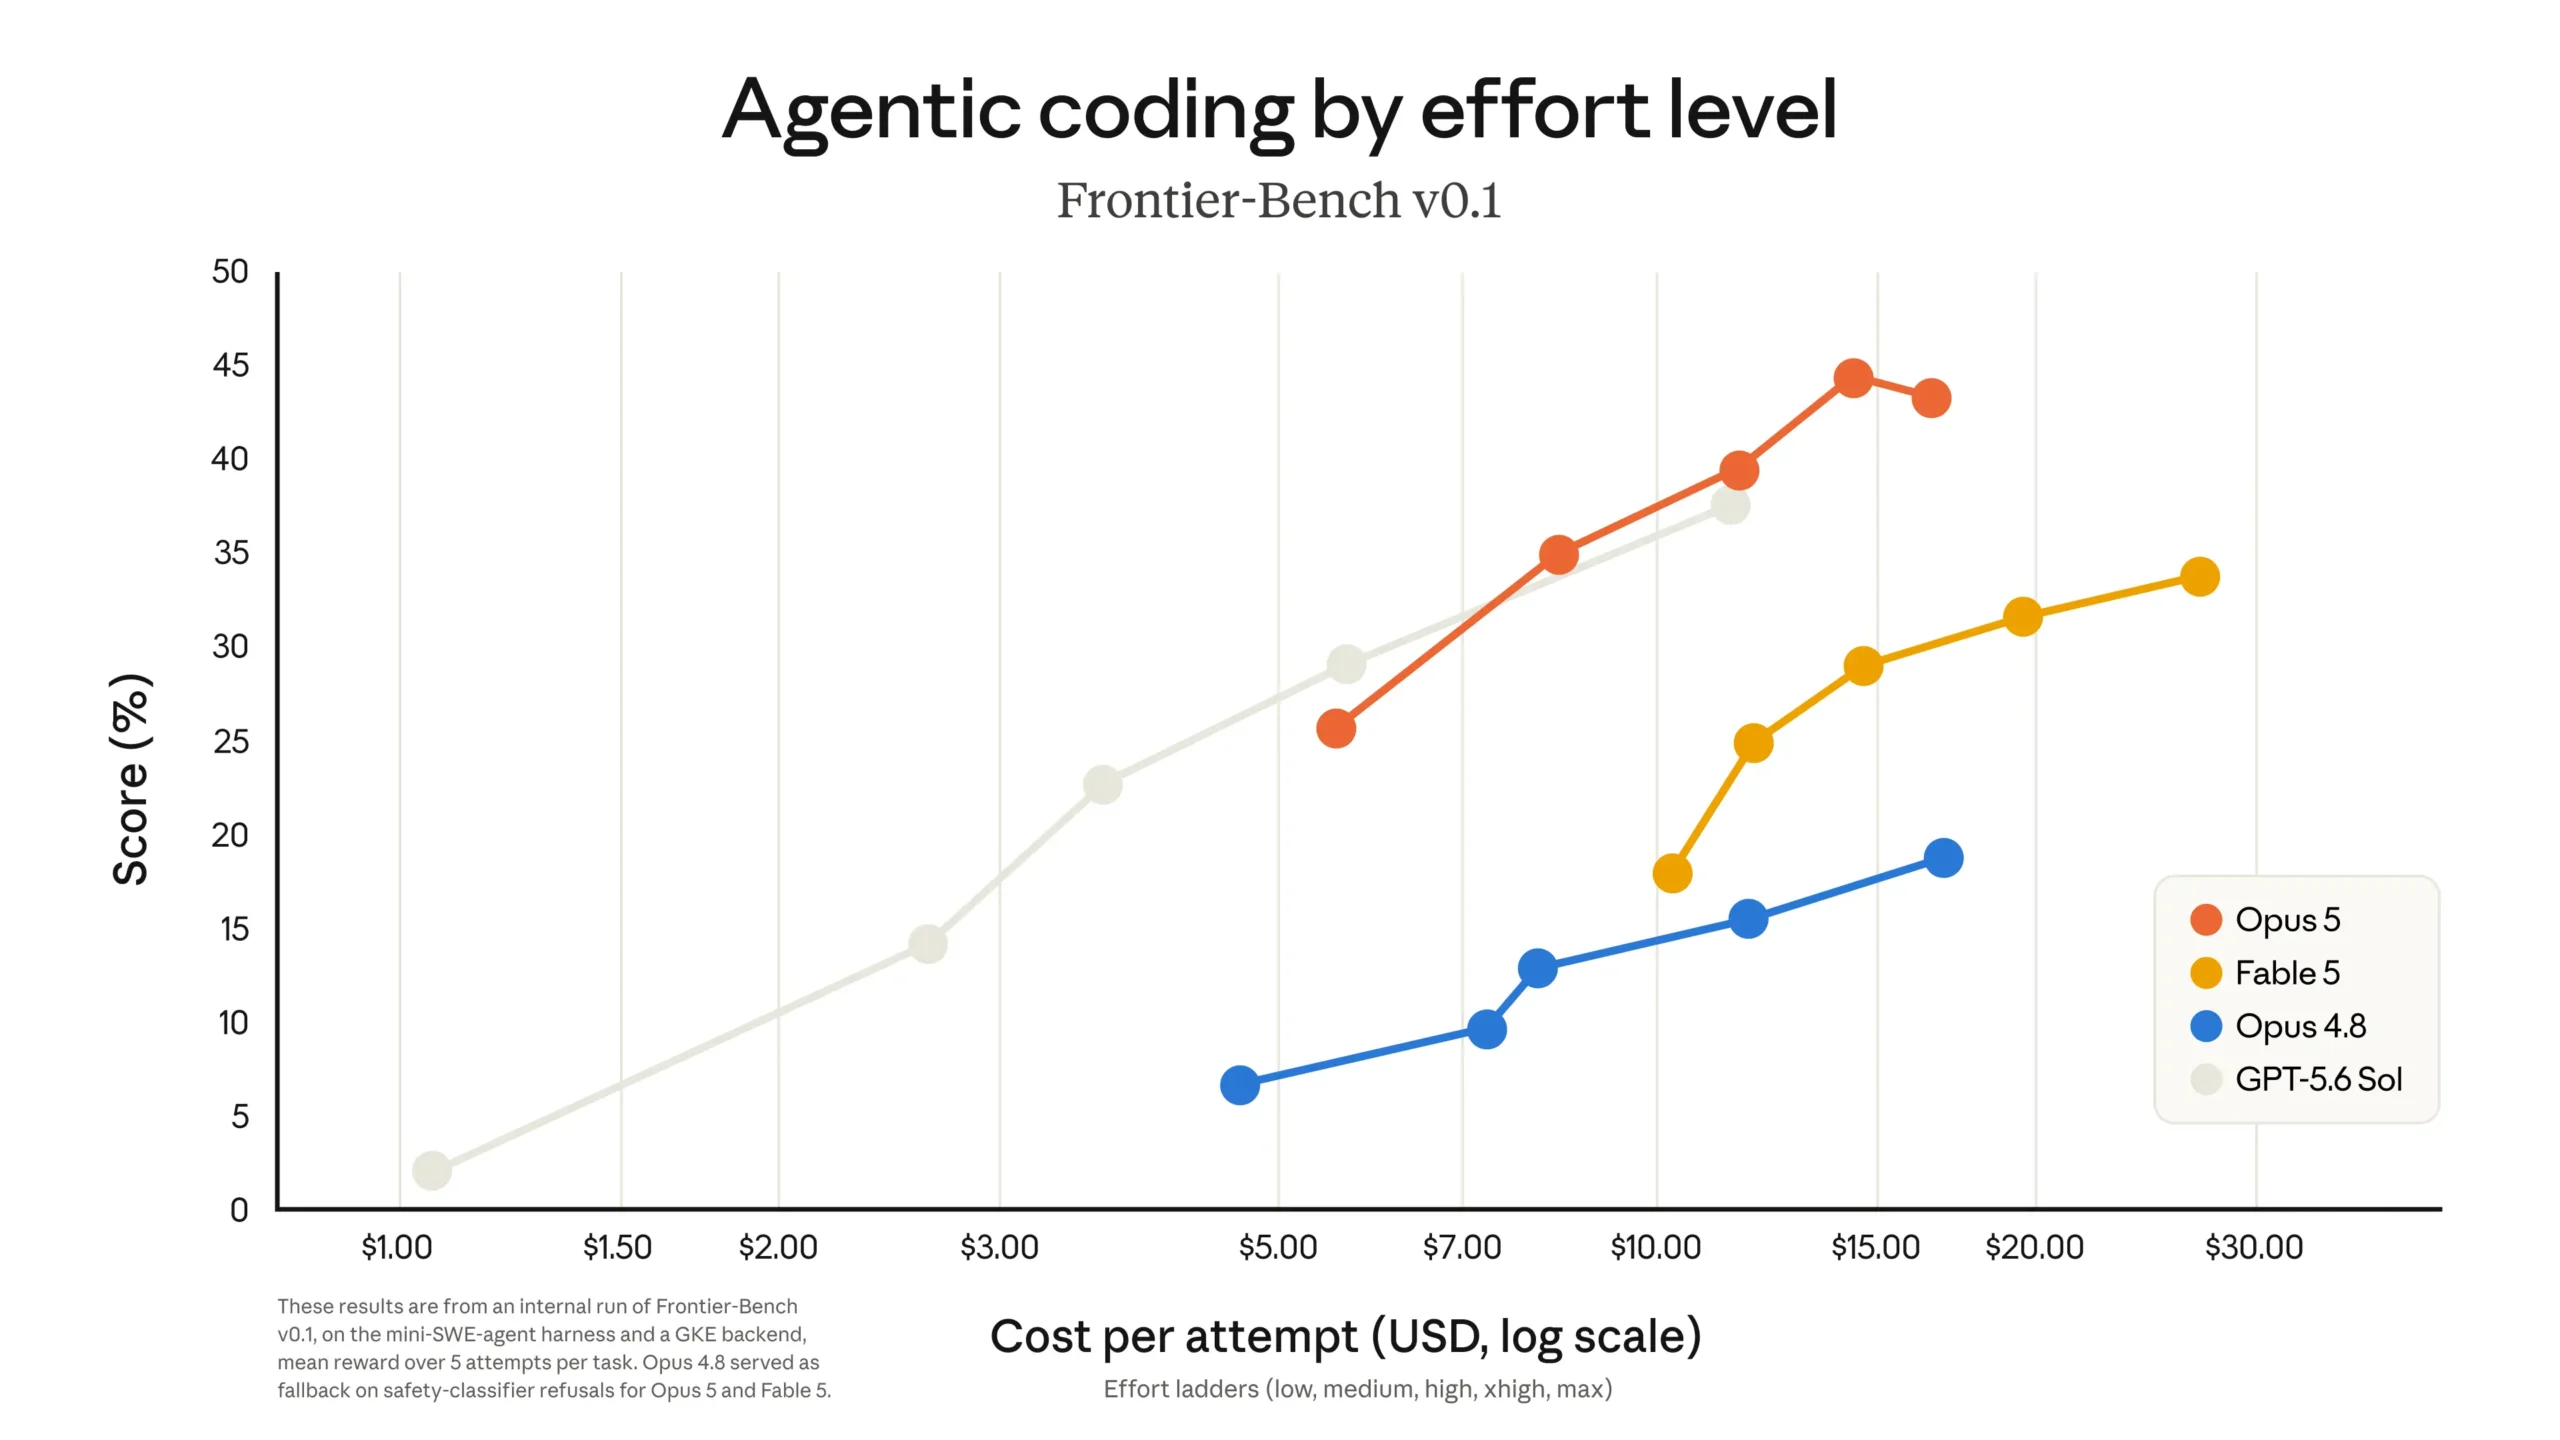
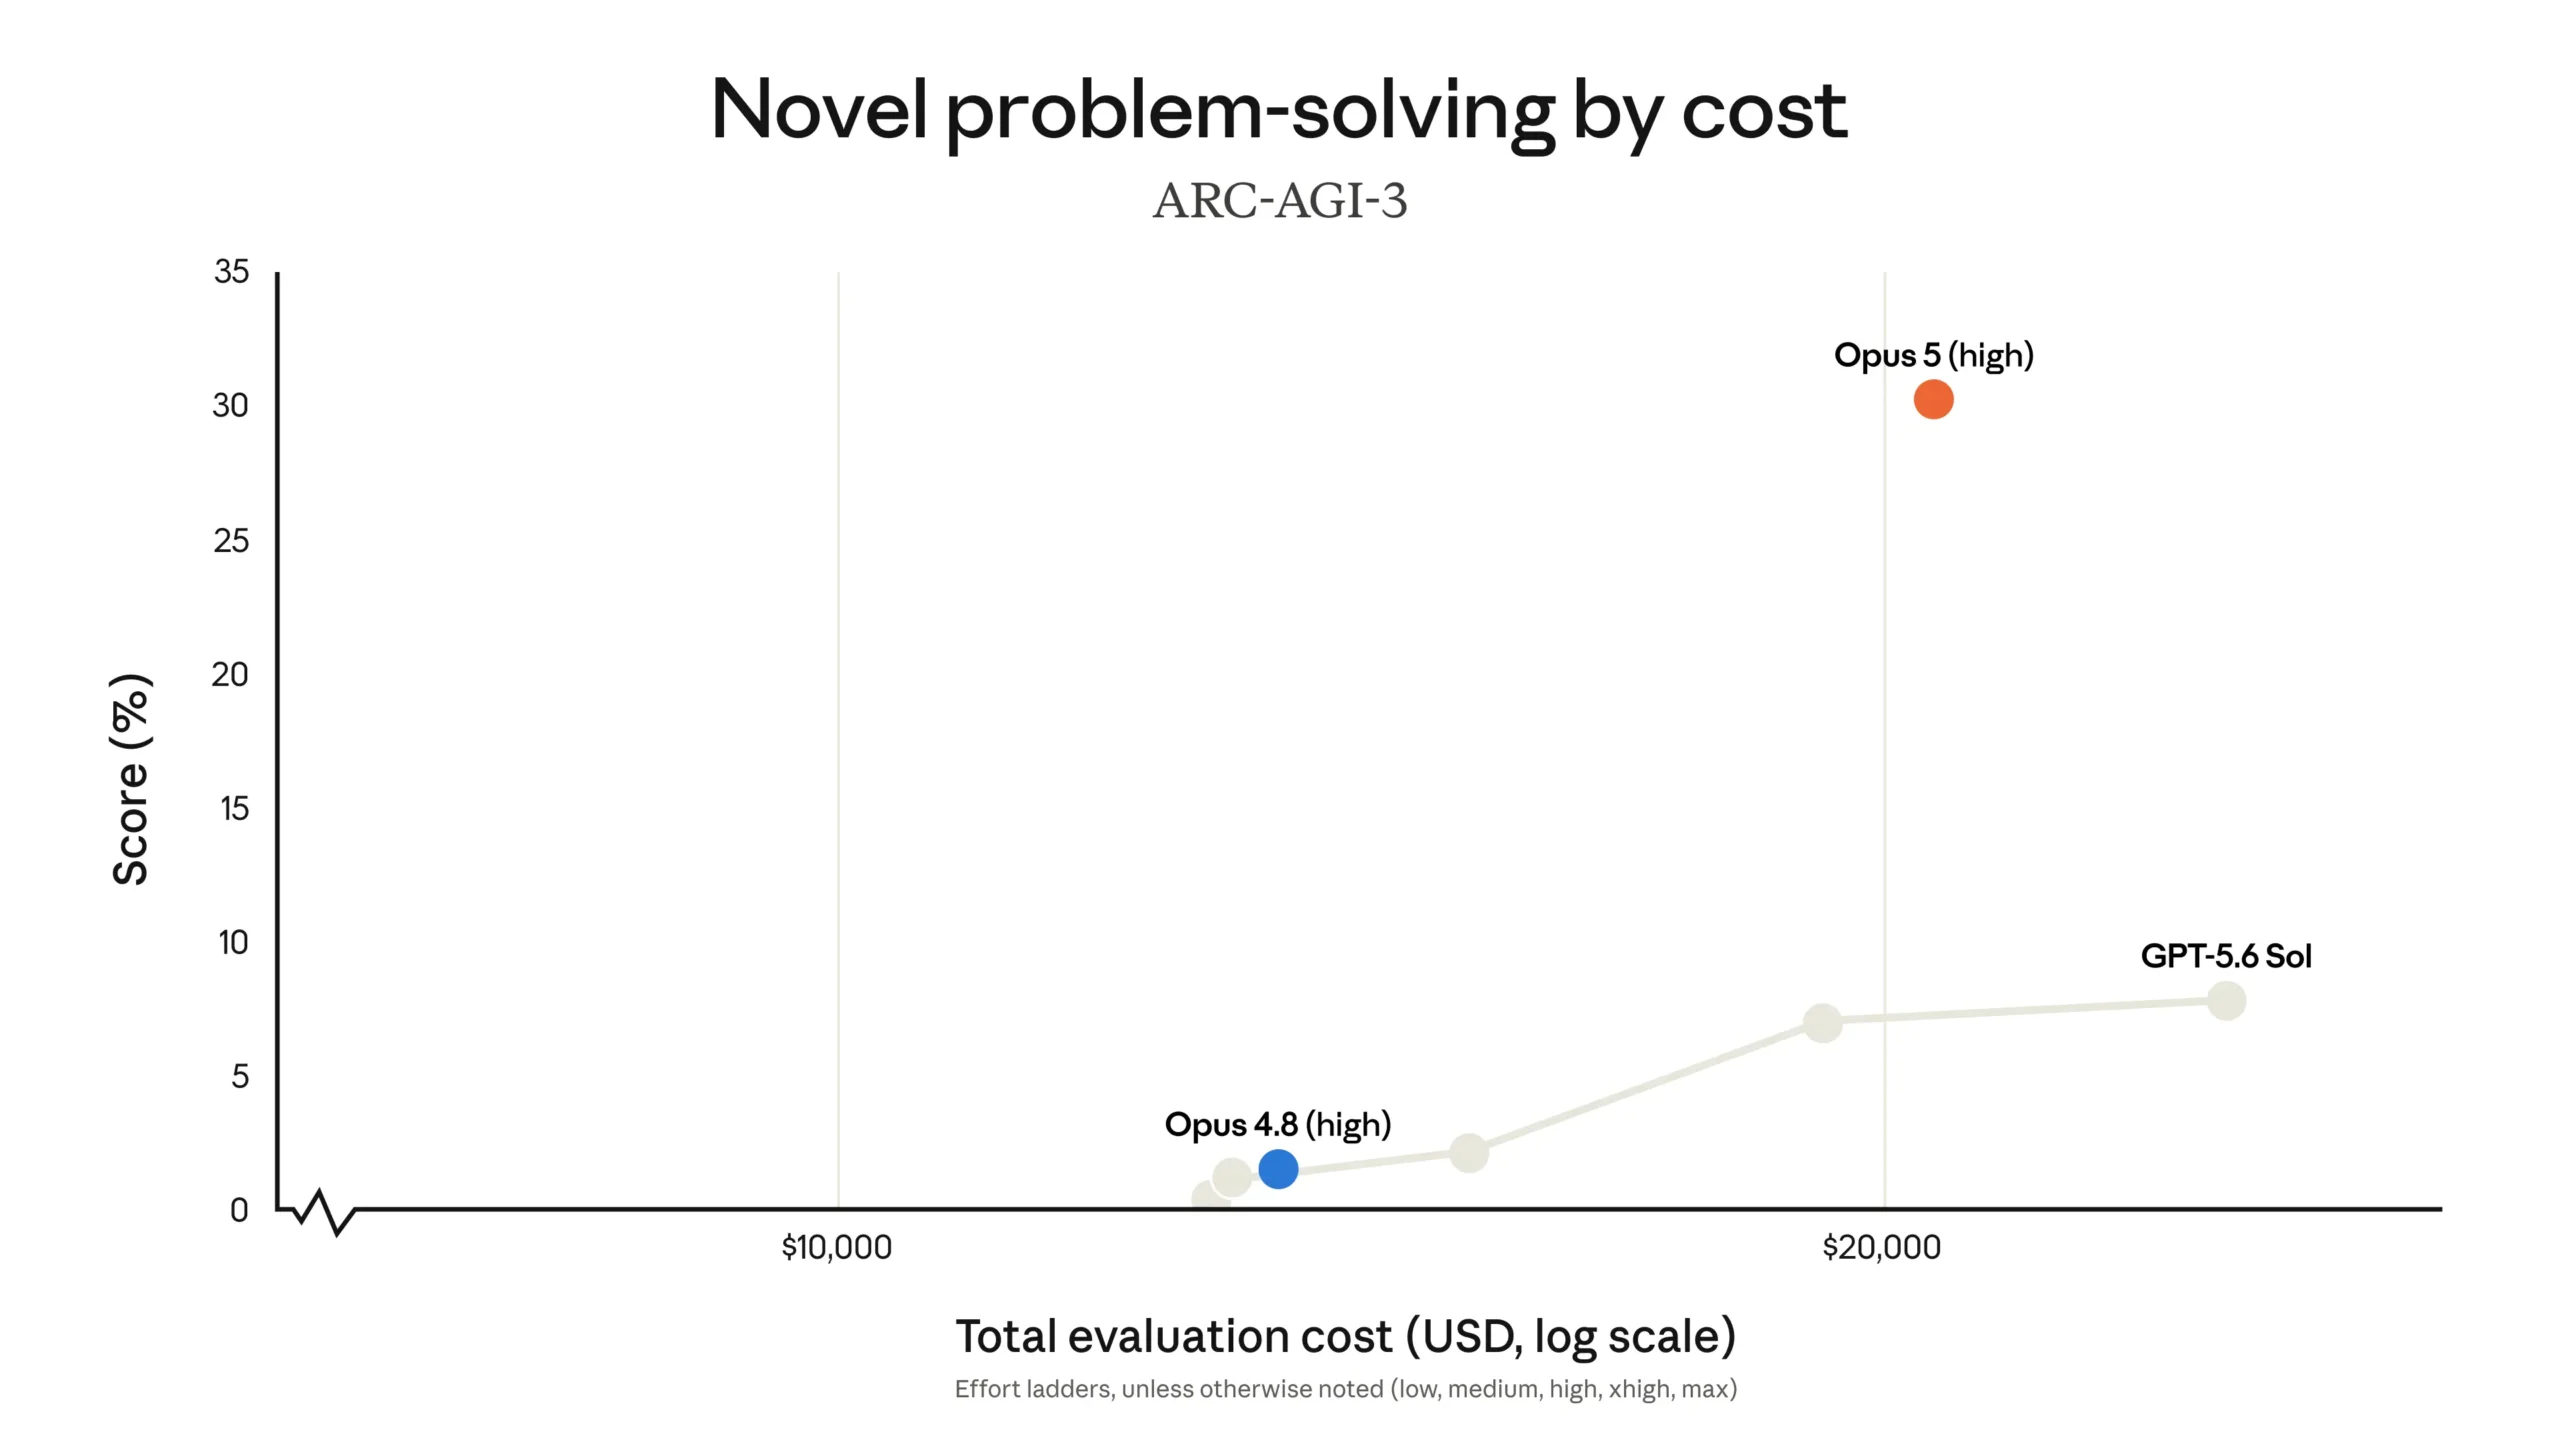
לפי Anthropic, claude opus 5 הציג ביצועים חזקים במבחני קוד כמו Frontier-Bench ו-CursorBench. במבחן Frontier-Bench v0.1, החברה דיווחה על ביצועים גבוהים מכל מודל אחר, ואף על יותר מפי שניים לעומת Opus 4.8.
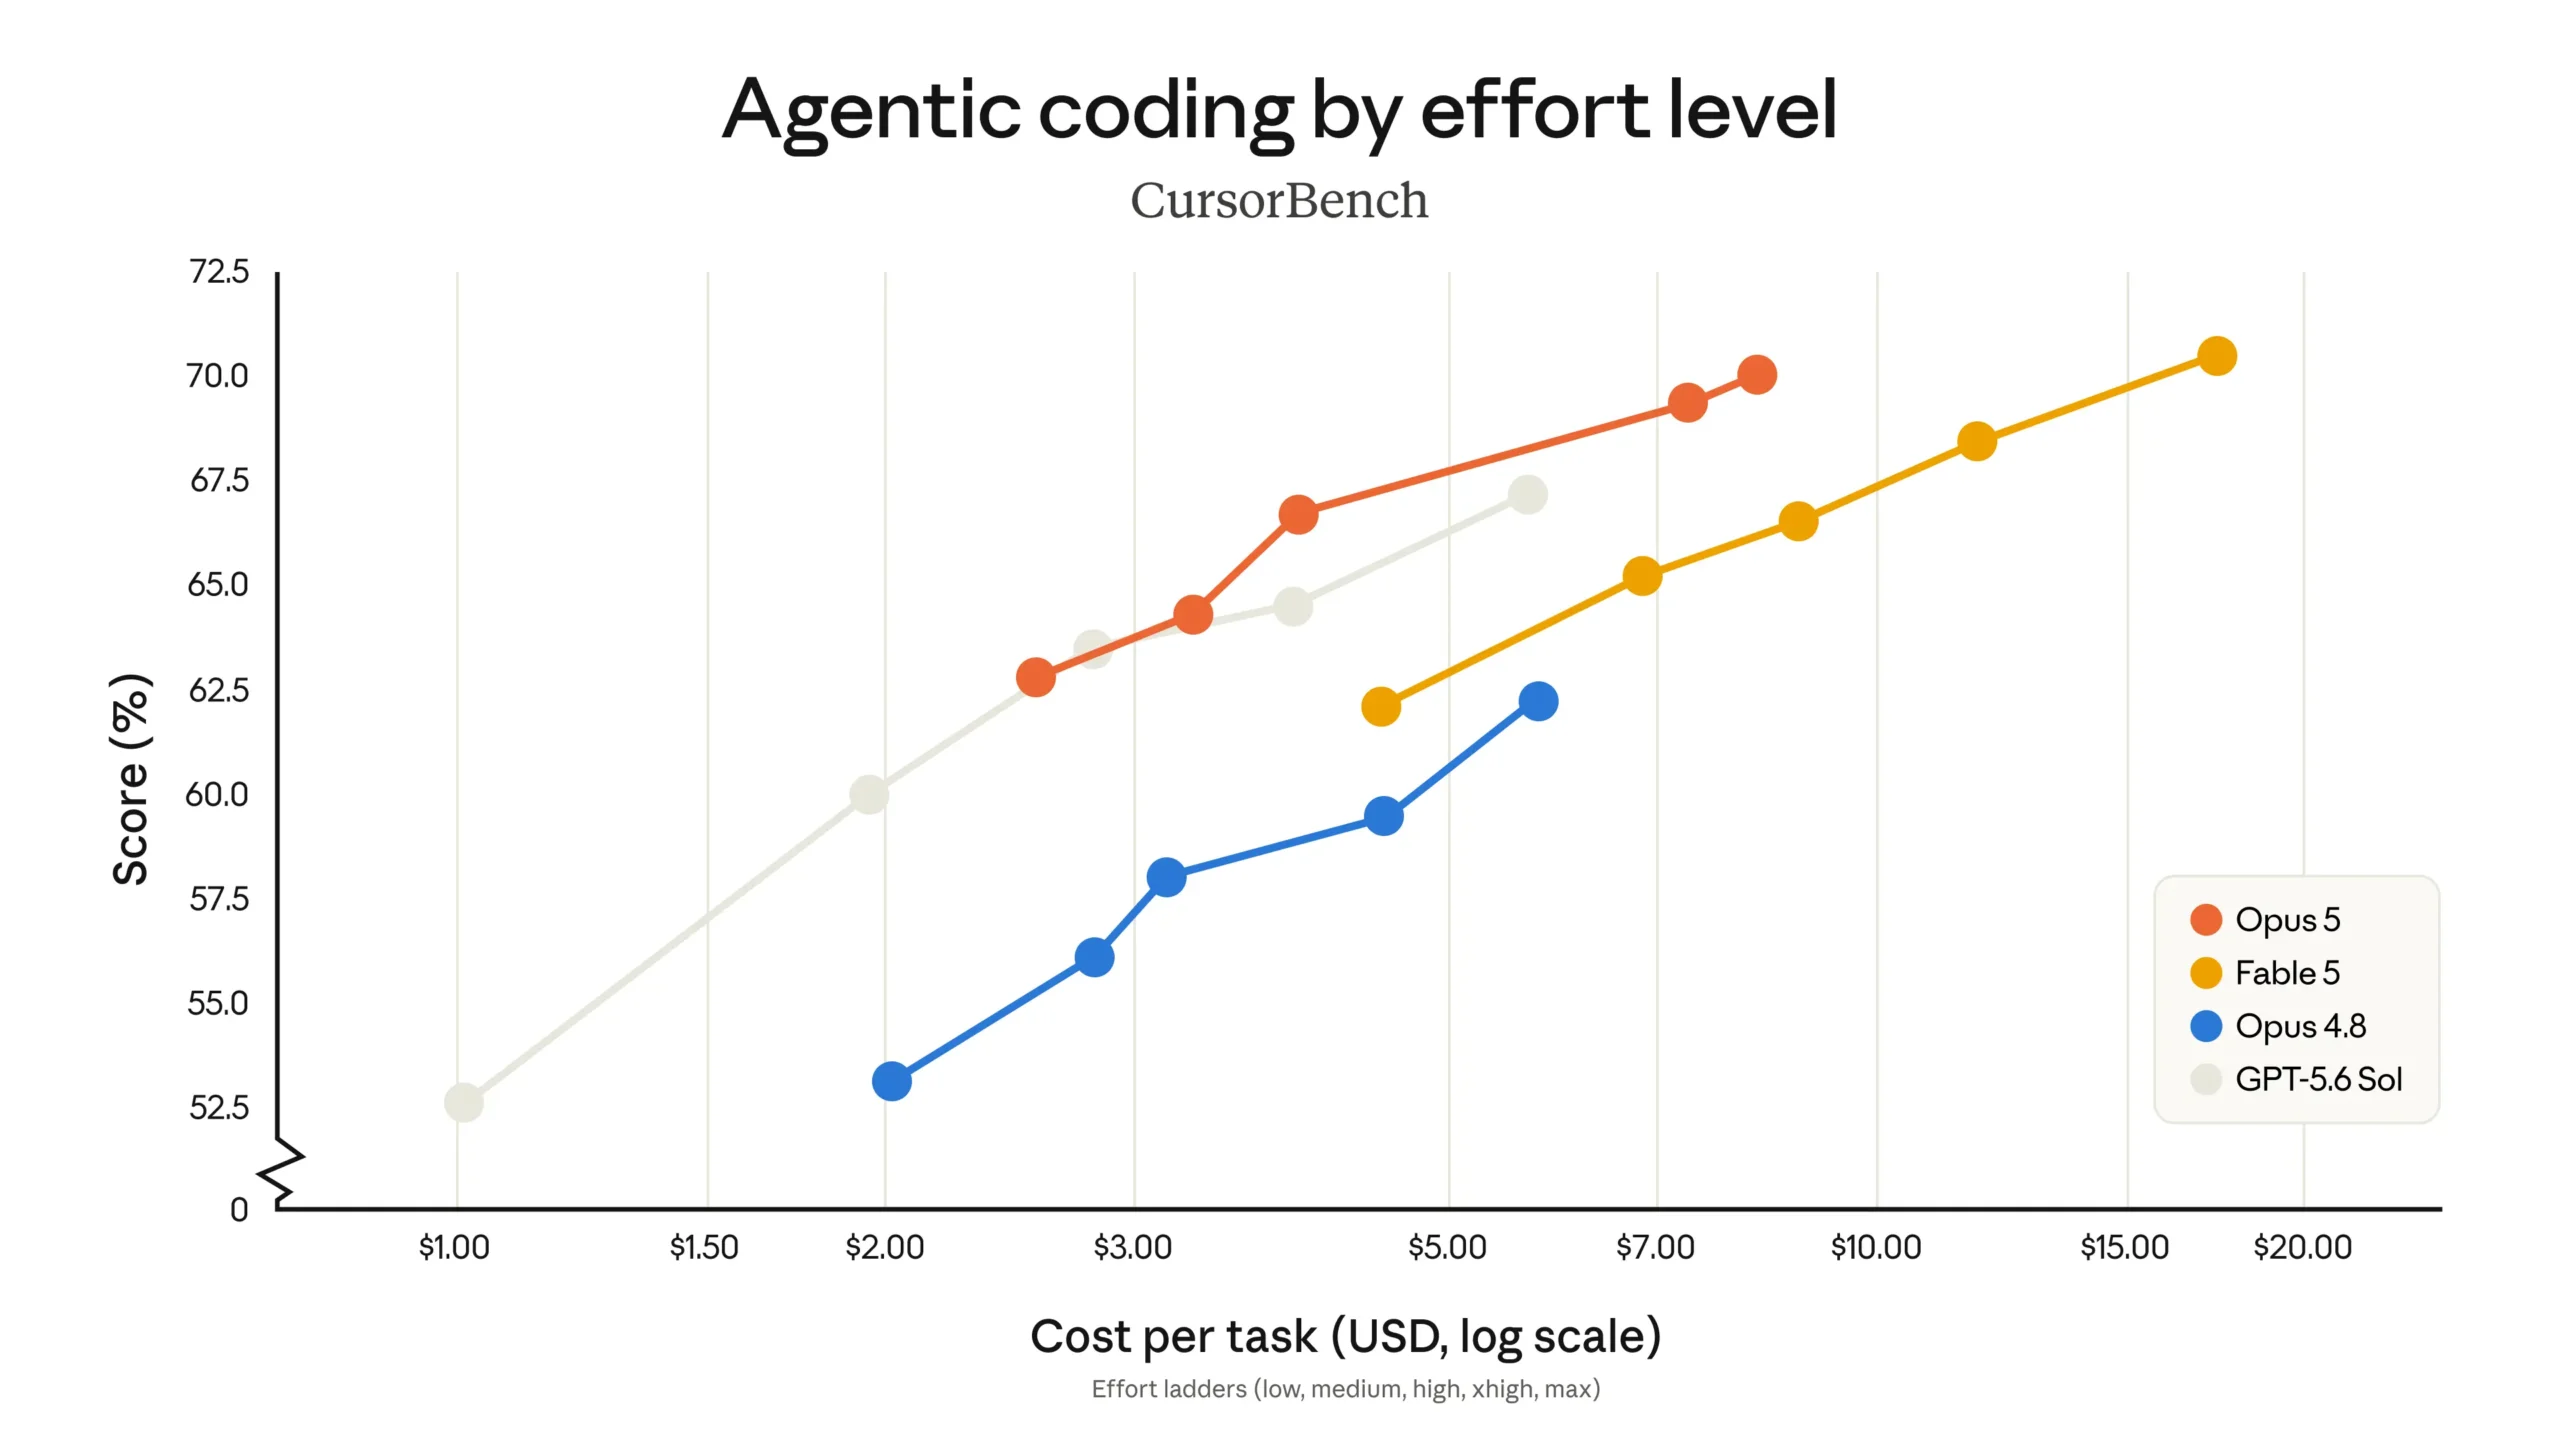
ב-CursorBench, ברמת המאמץ הגבוהה ביותר, המודל התקרב לציון השיא של Fable 5. לפי הנתונים שפורסמו, העלות למשימה הייתה בערך מחצית.
המשמעות המעשית חשובה לצוותי פיתוח. המודל יכול לעבוד עם הקשר רחב יותר, להבין כמה רכיבים במערכת ולהציע שינוי מקיף. הוא אינו מתמקד רק בשורת הקוד שבה התגלתה התקלה.
בדוגמה נוספת, המודל איתר שורש תקלה בחבילת קוד פתוח. הוא מצא מקרה קצה שהפתרון הקיים לא כיסה. זאת יכולת חשובה, משום שתיקון של סימפטום בלבד עלול ליצור ביטחון שגוי.
אוטומציות עסקיות מקצה לקצה
ב-Zapier AutomationBench, מבחן שבודק השלמת תהליך עסקי מלא, Anthropic דיווחה על שיעור הצלחה גבוה ביחס למודלים אחרים באותה עלות.
הדוגמה שסופקה עוסקת בנטישת לקוחות. המודל קיבל קובץ נתונים, זיהה חשבונות בסיכון, התריע לבעל התפקיד המתאים וסיכם את הממצאים לצוות השימור.
התהליך הזה מחבר כמה פעולות. הוא כולל קריאת מידע, קבלת החלטה, הפעלת מערכת ודיווח. כאן סוכן AI יכול לחסוך זמן אמיתי, אך הוא עדיין זקוק להרשאות מוגבלות ולבקרה אנושית.
עבודה עם מחשב וממשקים
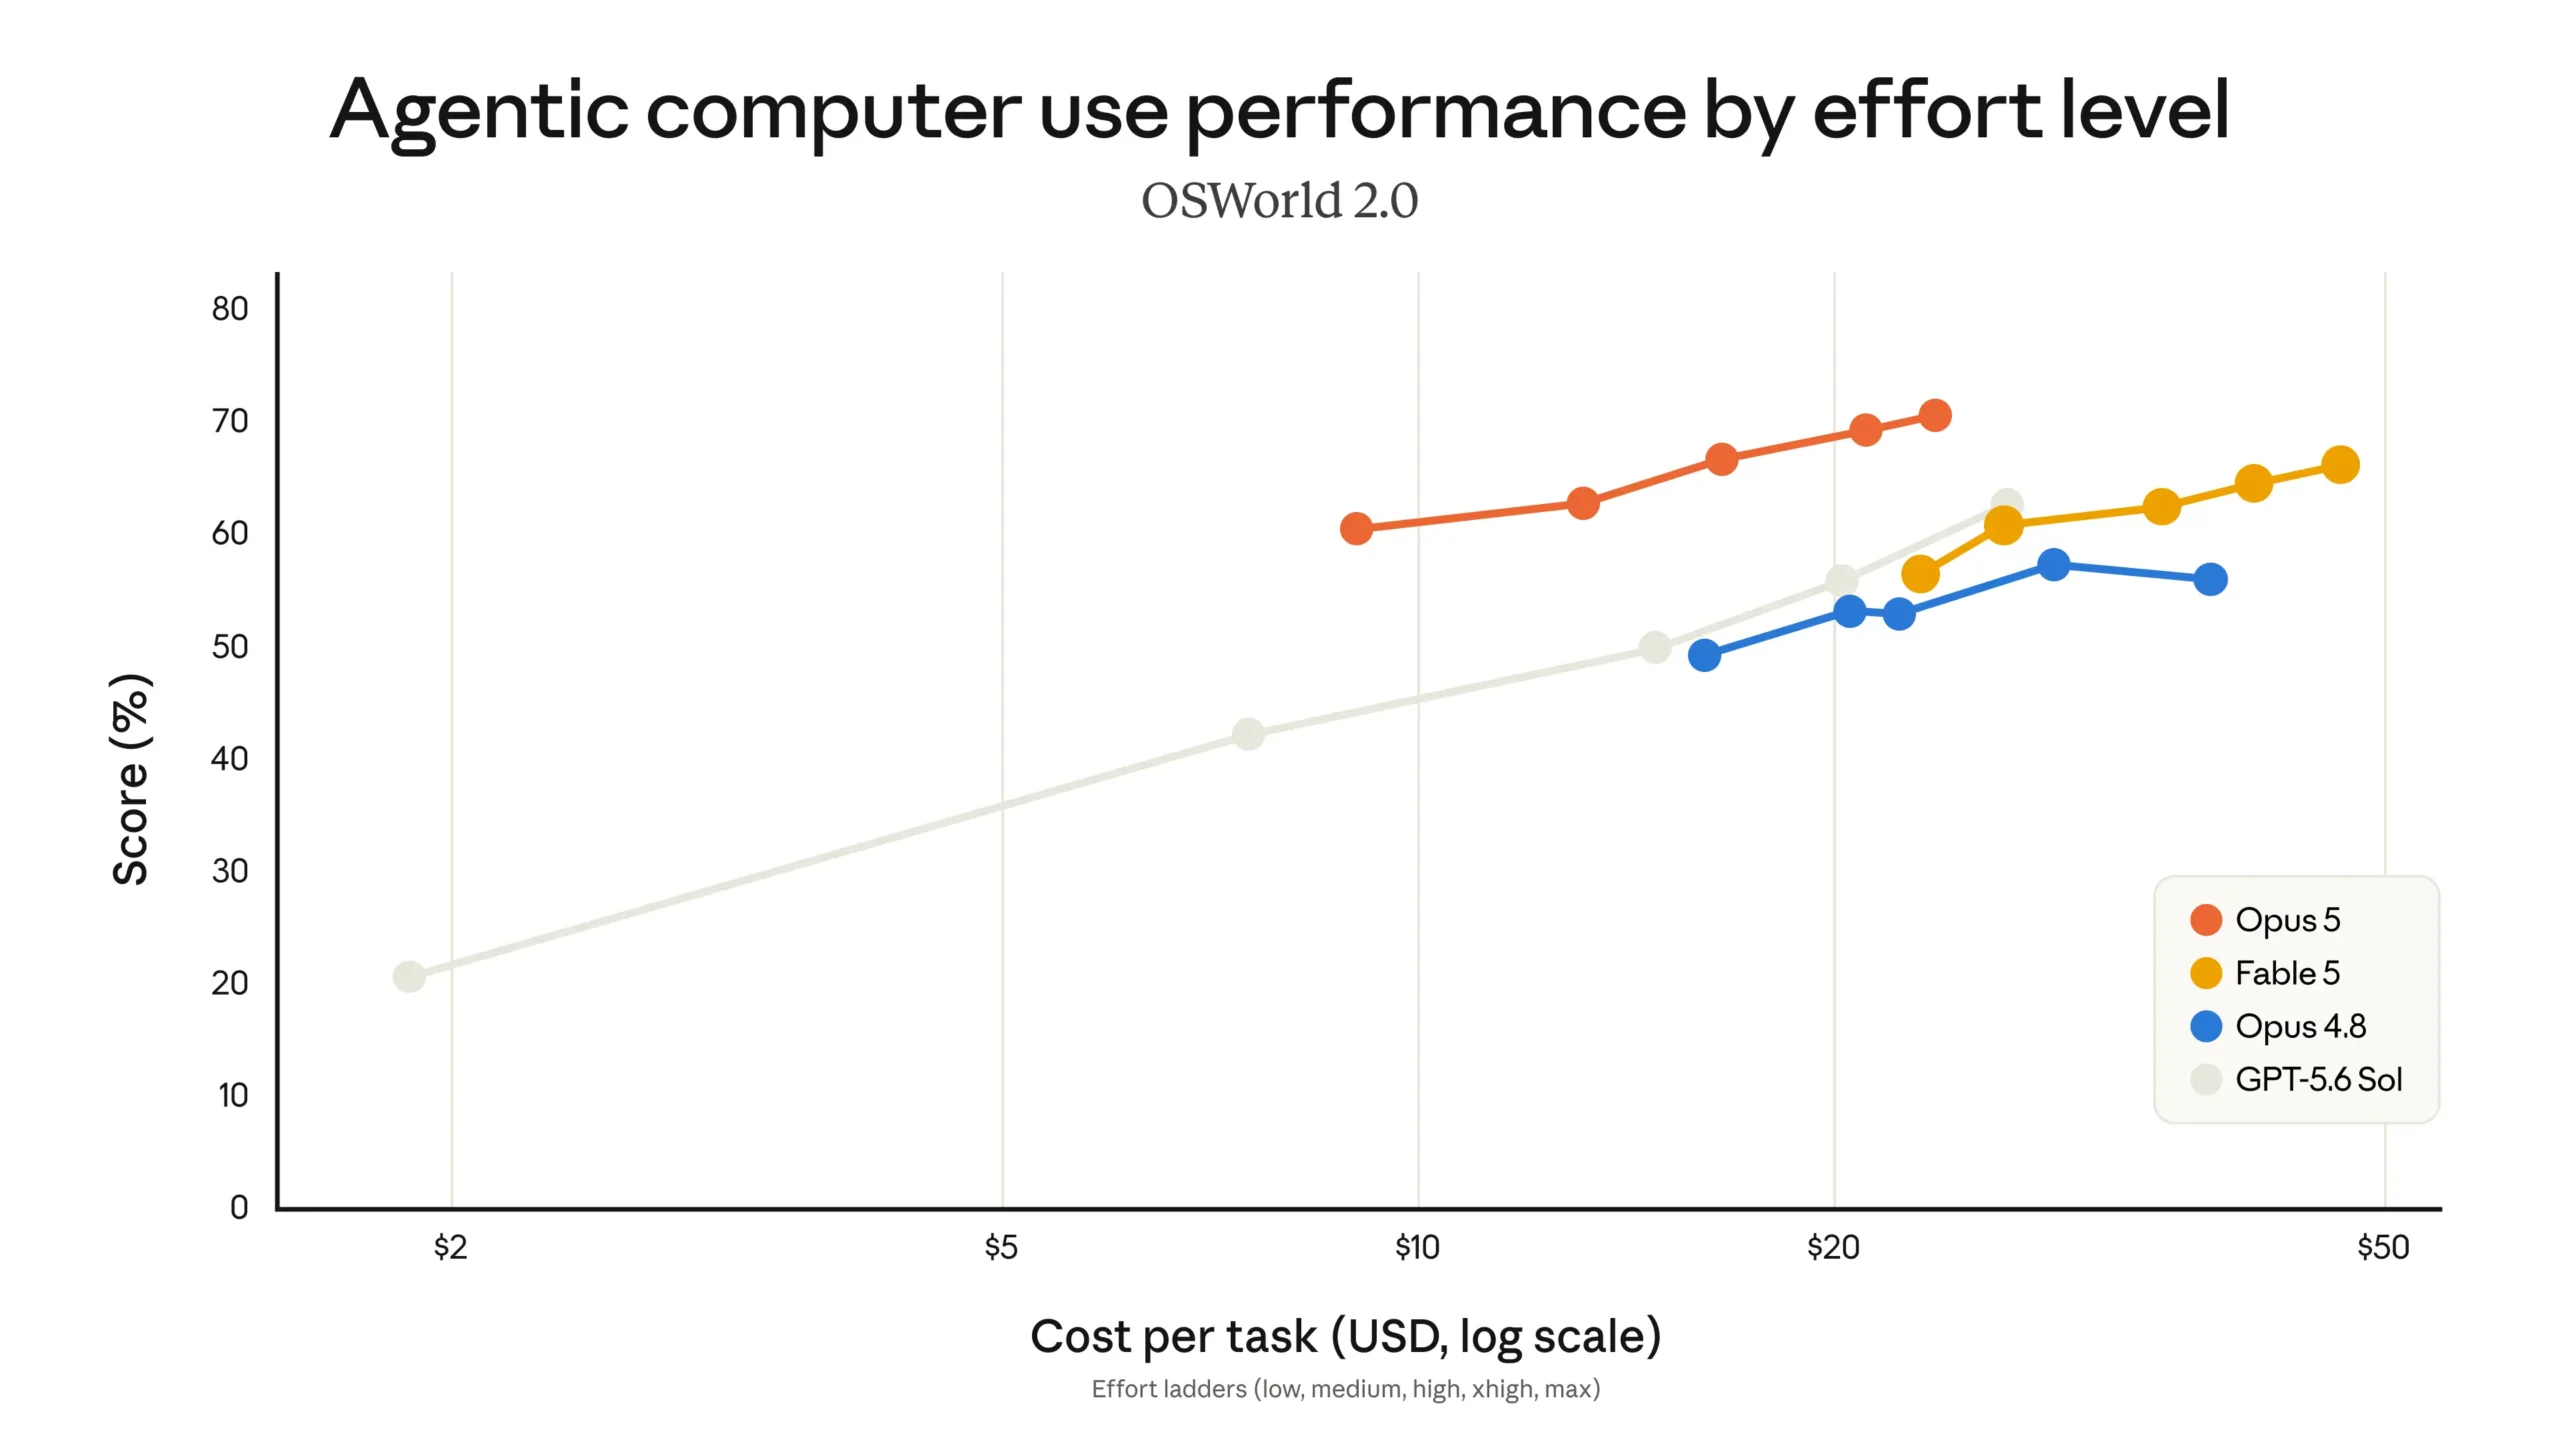
ב-OSWorld 2.0, מבחן לשימוש במחשב, Anthropic דיווחה על ביצועים גבוהים ביחס לעלות. המודל מסוגל לאתר כפתורים, לעבוד עם חלונות ולהשלים פעולות על המסך.
בדוגמה שנמסרה, המודל בדק ממשק בכמה גדלי מסך. הוא זיהה כפתור רכישה שנמצא מחוץ לתצוגה ותיקן את הבעיה.
למנהלי מוצר ולצוותי פיתוח זהו יתרון מעשי. סוכן שבודק את התוצאה בעצמו יכול להפחית תקלות שמגיעות לשלב הבדיקה האנושית.
מחקר, מסמכים וניתוח נתונים
לפי Anthropic, claude opus 5 מציג שיפור במשימות מדעיות, כולל ביולוגיה מבנית, כימיה אורגנית וביואינפורמטיקה.
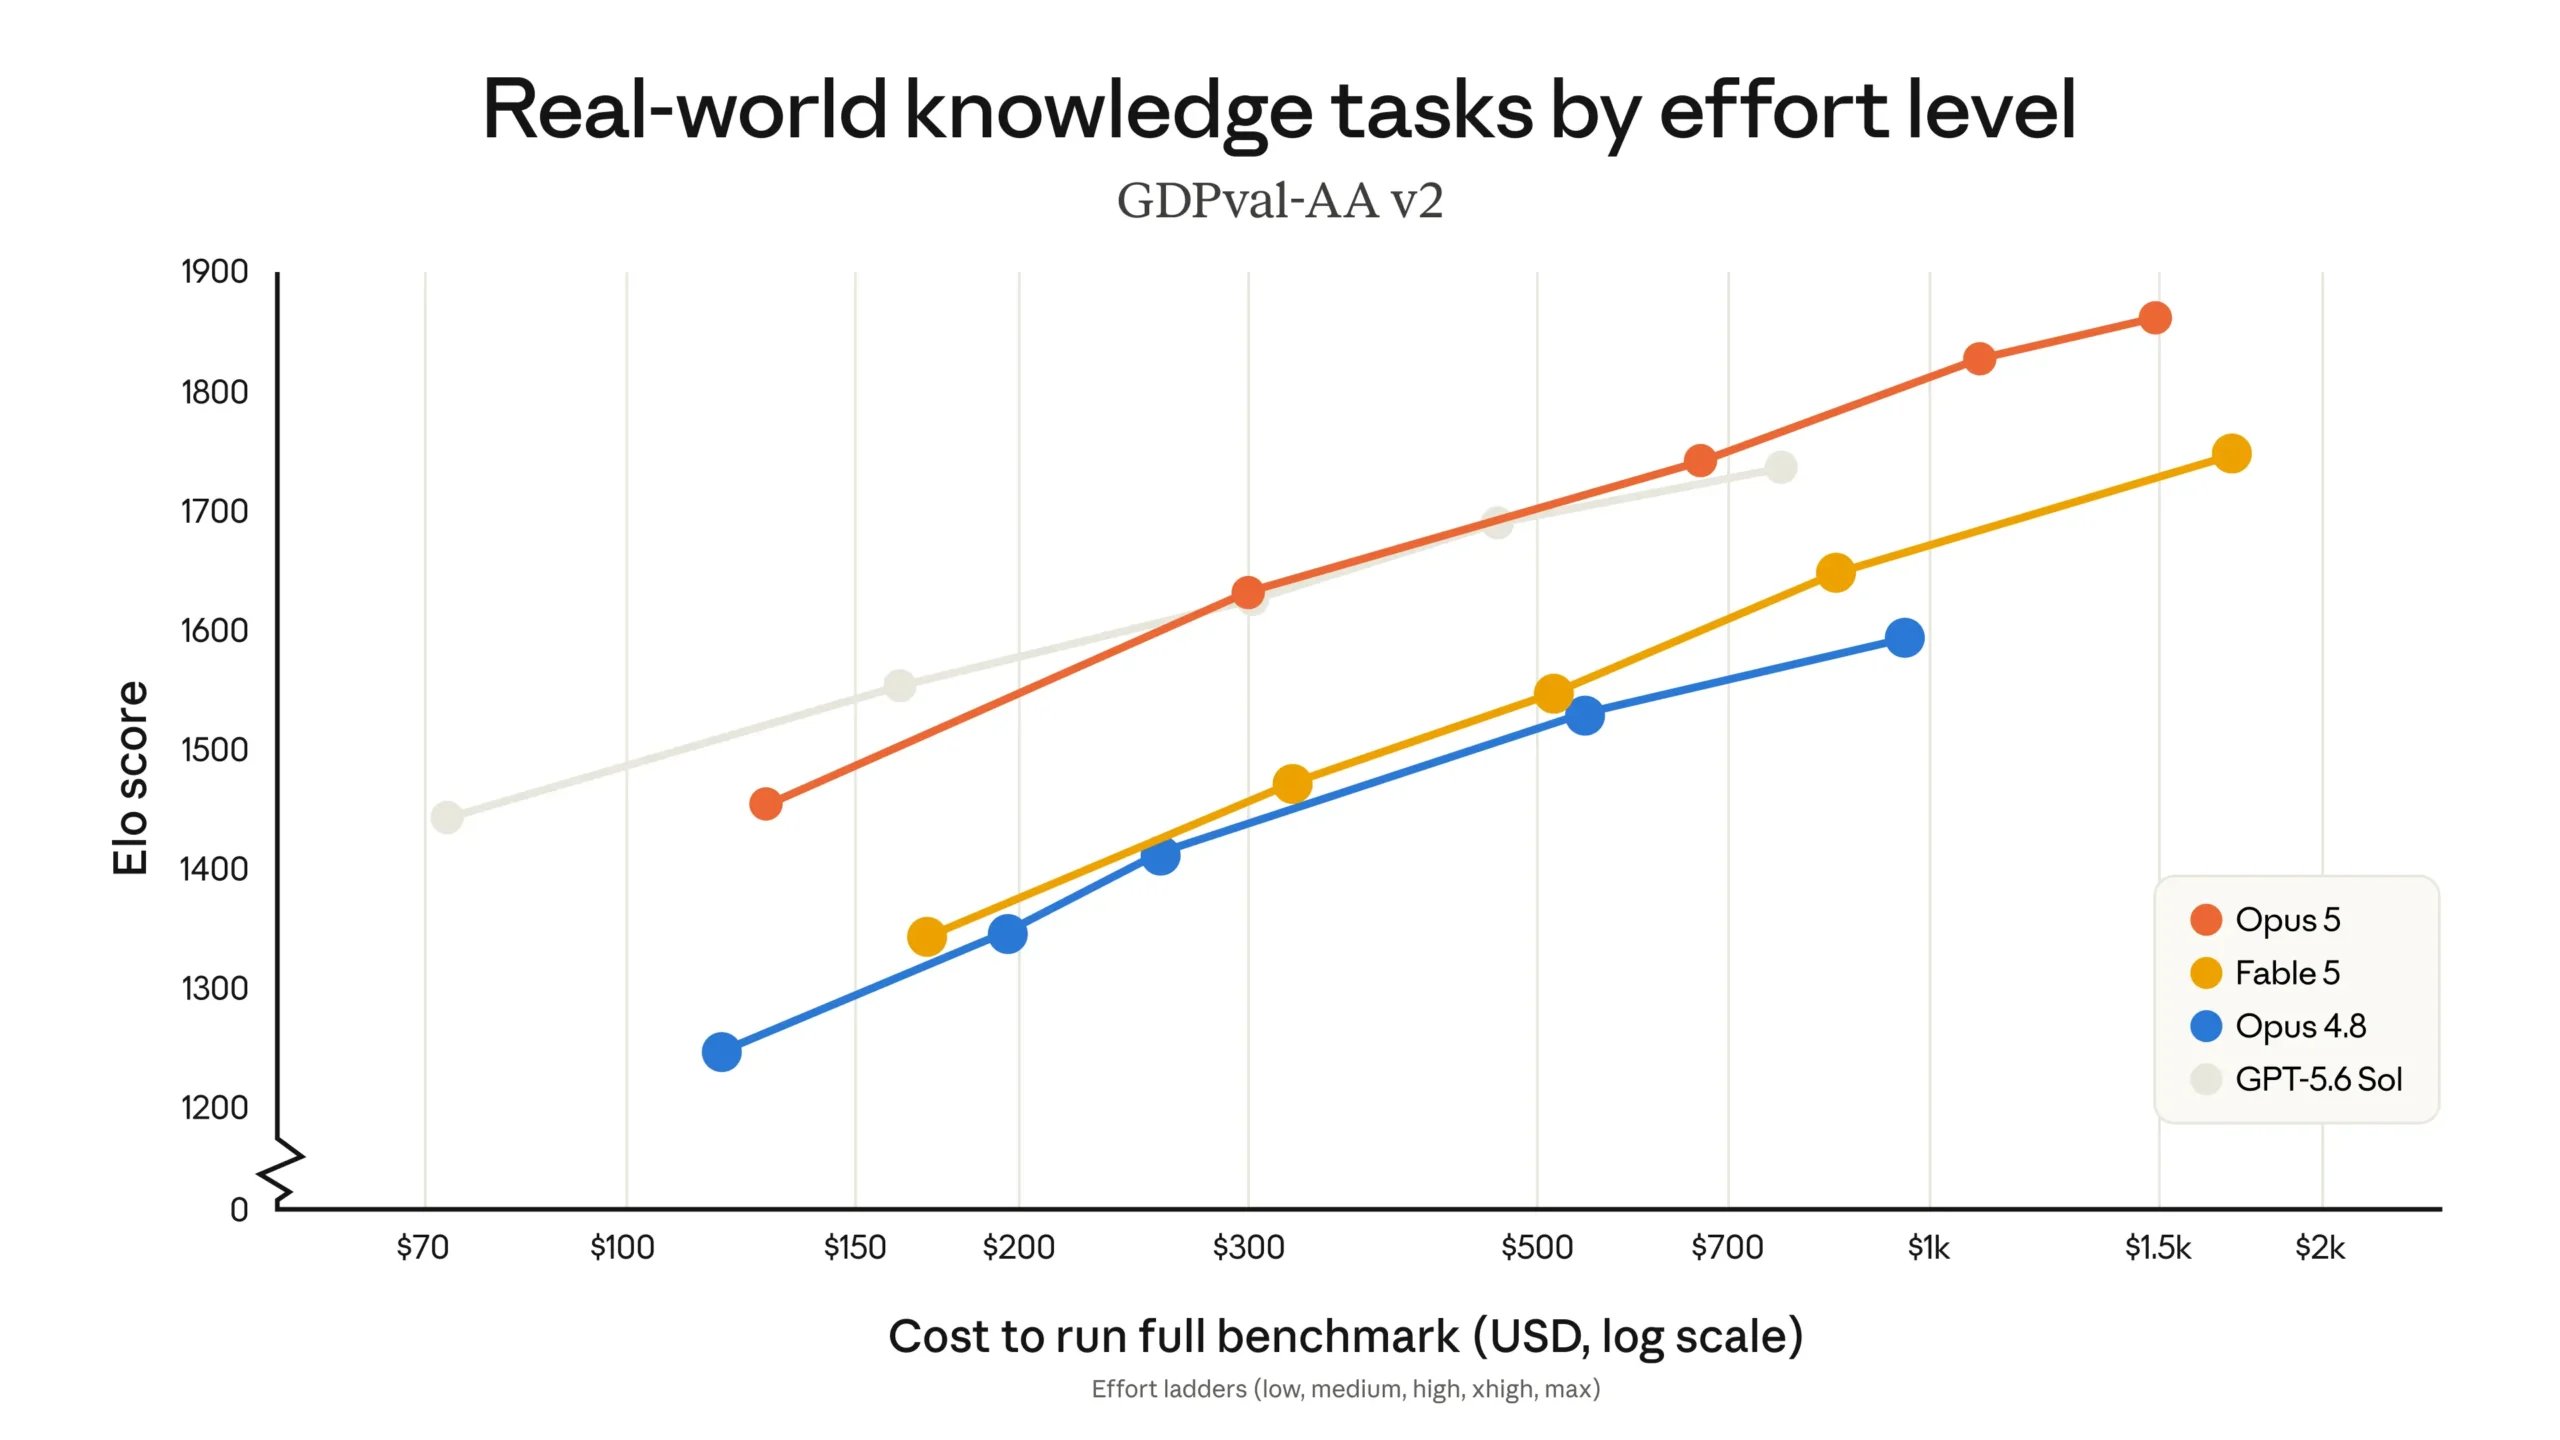
המודל מתאים גם לניתוח מסמכים עסקיים, בדיקת נאותות, סקירת טבלאות וניסוח דוחות. Box דיווחה על שיפור של 8% לעומת Opus 4.8 במשימות תוכן ארגוני.
הנתונים האלה מגיעים מהחברות עצמן. לכן הם מספקים כיוון, אך אינם מחליפים בדיקה עצמאית מול מסמכים, תהליכים וסיכונים של הארגון.
איך להבין את הגרפים והמבחנים?
לא סופקו בגרסה זו תמונות או גרפים מקוריים. לכן אי אפשר להסביר ממדים חזותיים שלא צורפו, כמו צירים, יחידות מדידה, מקרא או קבוצות השוואה.
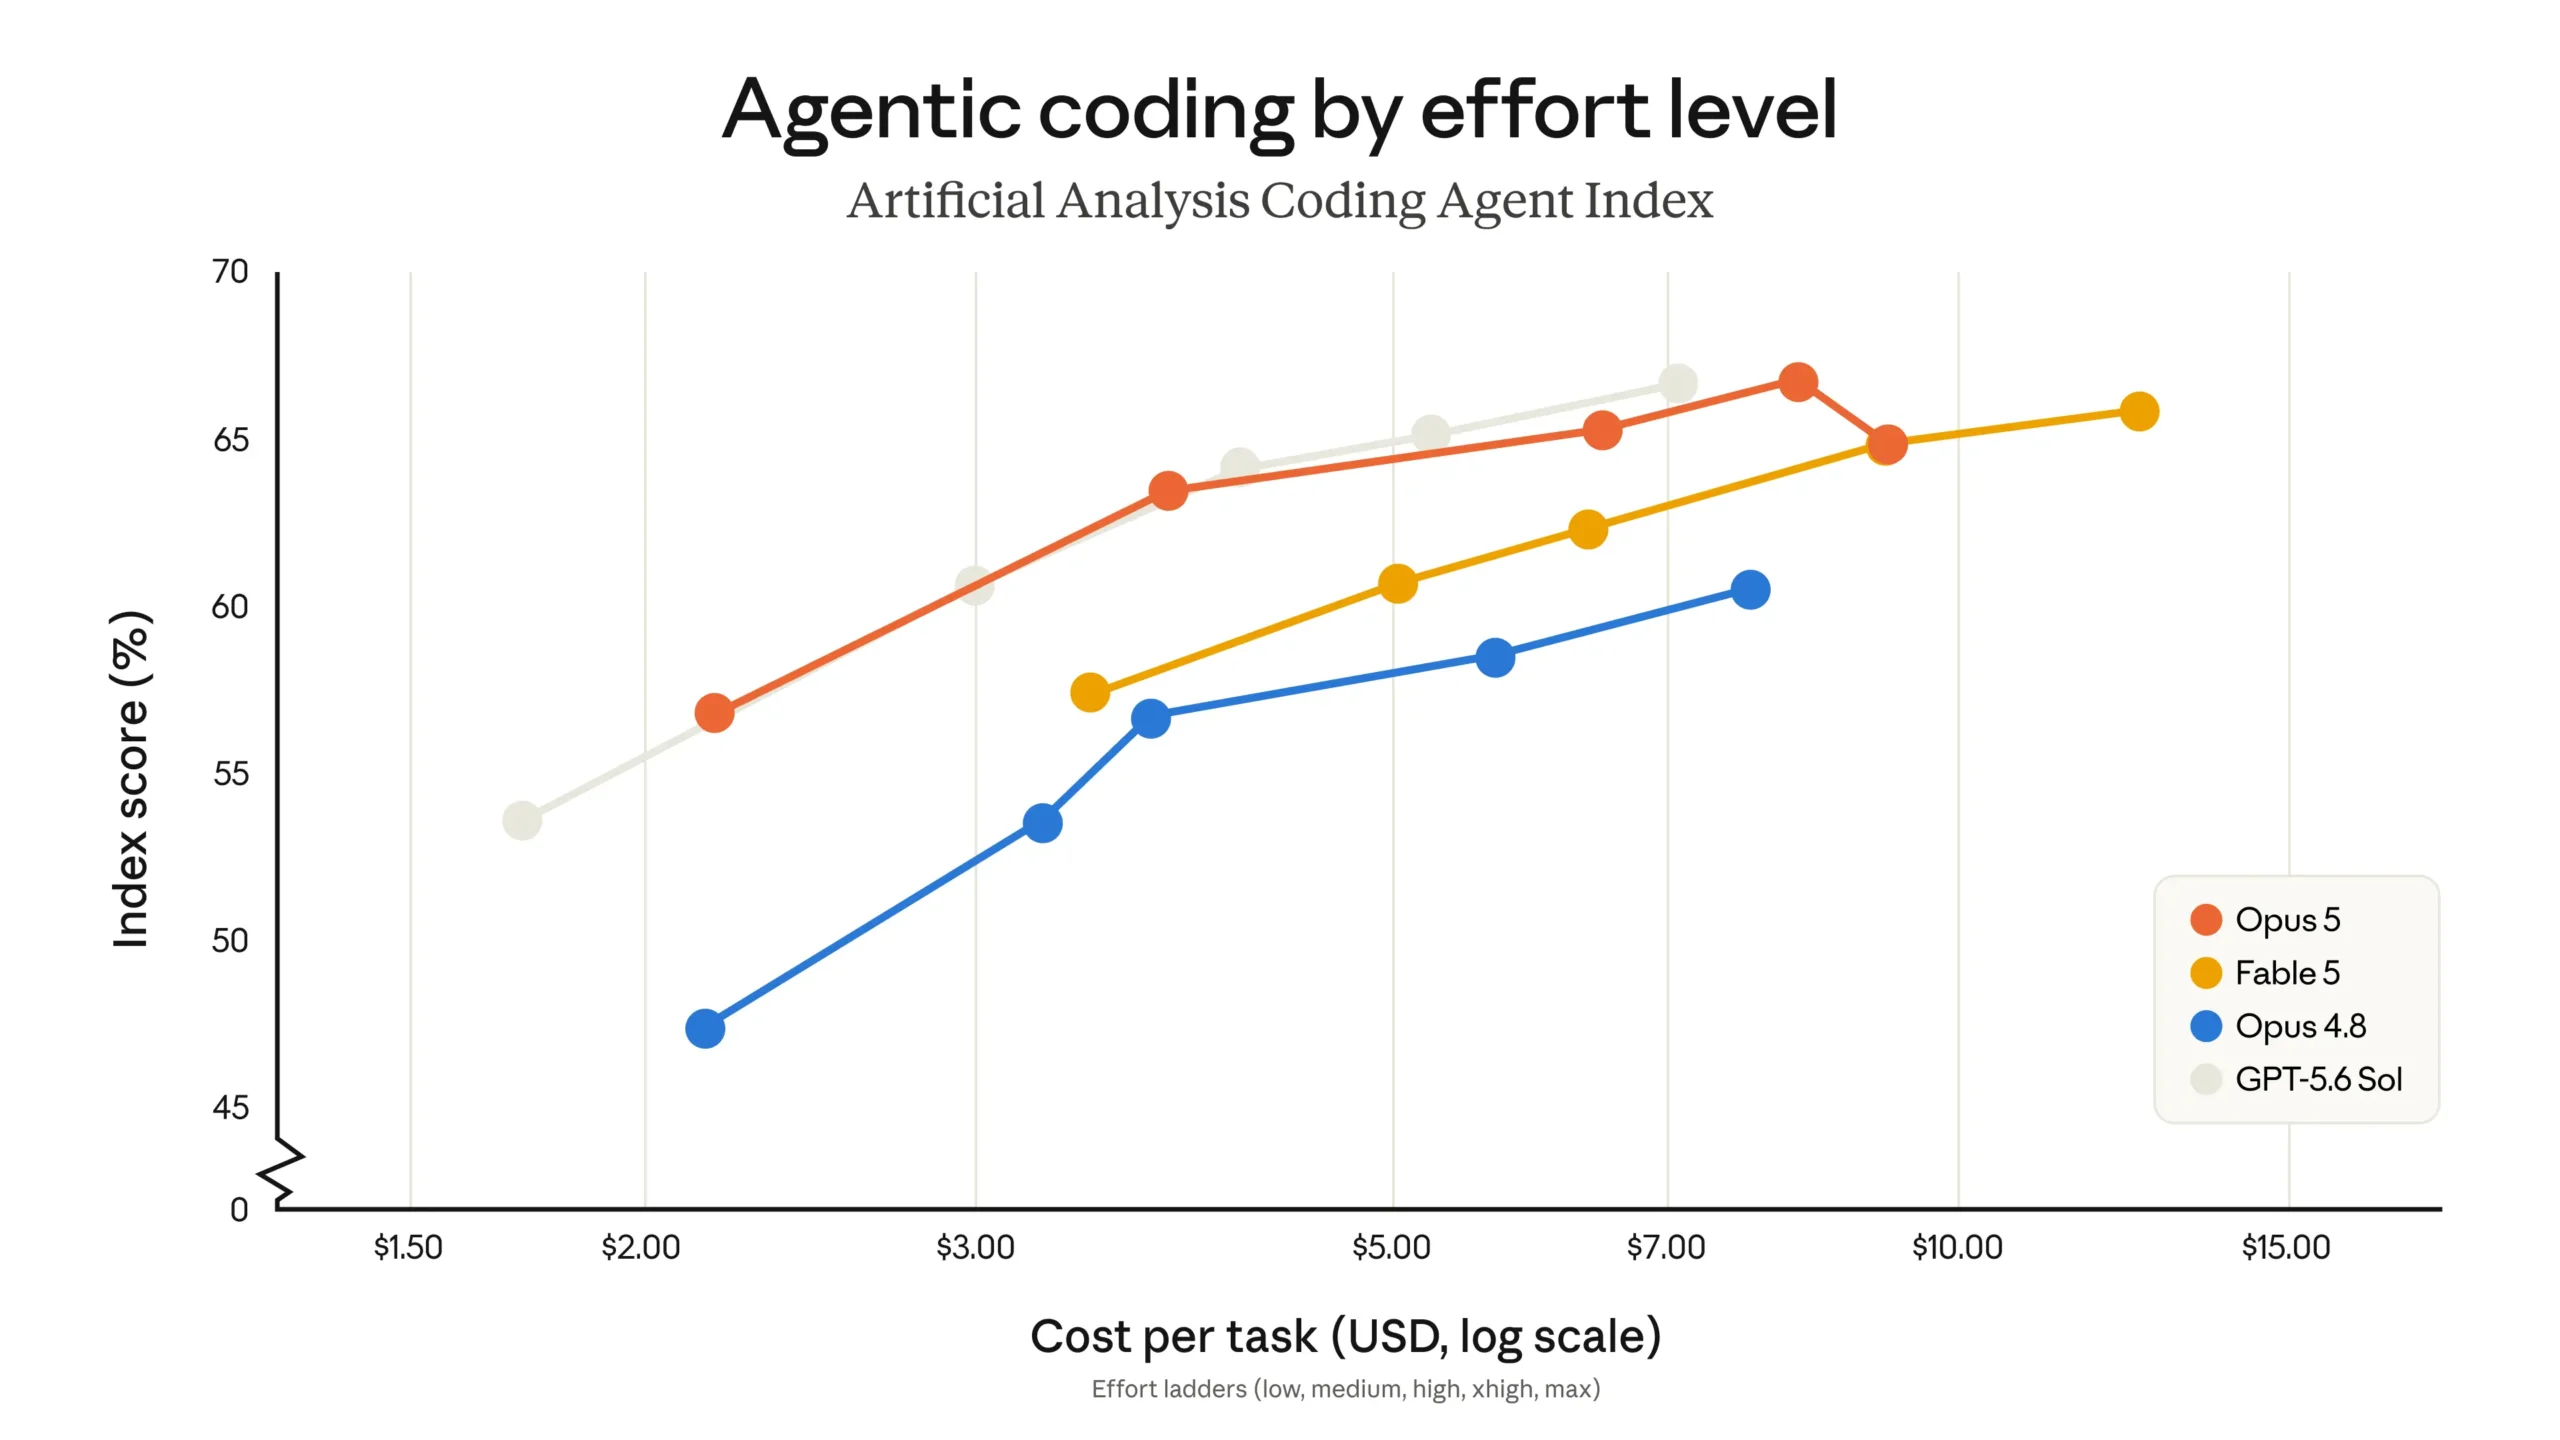
עם זאת, לפי הנתונים בטקסט, כמה ממדים חוזרים לאורך ההשוואות. הממד הראשון הוא ביצועים, כלומר עד כמה המודל הצליח להשלים את המשימה. הממד השני הוא עלות, כלומר כמה משאבים נדרשו להשלמתה.
הממד השלישי הוא רמת מאמץ. מודל יכול להשקיע יותר זמן חישוב, להשתמש ביותר כלים ולבצע בדיקות נוספות. הממד הרביעי הוא סוג המשימה, למשל קוד, אוטומציה, ניתוח מסמכים או שימוש במחשב.
כאשר קוראים גרף כזה, לא כדאי לבחון רק את העמודה הגבוהה ביותר. צריך לבדוק גם את העלות, את מספר הסבבים, את רמת המאמץ ואת איכות התוצאה בפועל.
איפה צריך להיזהר?
מבחנים אינם תחליף לפיילוט
המקורות מציגים תמונה חיובית, אך התוצאות אינן אחידות בכל תחום. לפי חומר המקור, נרשמו ירידות מסוימות במבחנים משפטיים ובריאותיים לצד שיפור משמעותי במבחנים אחרים.
גם רמת החשיבה, מספר הכלים והגדרת המשימה משפיעים על התוצאה. לכן, לפני מעבר לסביבת ייצור, כדאי להפעיל פיילוט על דוגמאות אמיתיות.
בפיילוט מודדים דיוק, זמן, עלות, מספר תיקונים ושיעור משימות שהושלמו. בנוסף, בודקים כמה זמן אדם עדיין משקיע בתהליך.
בטיחות והרשאות
Anthropic מציגה את claude-opus-5 כמודל המיושר ביותר שלה עד כה. לפי החברה, הוא מציג שיעורים נמוכים יותר של התנהגות מטעה ופעולות פזיזות.
החברה גם מציינת שהמודל נשאר מאחורי Mythos 5 ביכולות סייבר התקפיות ובחלק ממשימות הביולוגיה המסוכנות. עדיין, מודל חזק עלול לטעות, לפרש מידע באופן שגוי או לבצע פעולה לא רצויה.
דרך תיעוד הבטיחות ומגבלות השימוש אפשר לבדוק את ההנחיות הרלוונטיות לפני הטמעה.
בעבודה ארגונית, לא נותנים למודל הרשאות רחבות ללא צורך. מגדירים גבולות, מתעדים פעולות ומשאירים אדם בתהליך כאשר קיימת השפעה כספית, משפטית או תפעולית.
תהליך הטמעה מעשי בעסק
- בוחרים תהליך מדיד. מתחילים במשימה חוזרת עם קלט ופלט ברורים.
- מכינים סט בדיקה. אוספים דוגמאות אמיתיות ומגדירים מה נחשב הצלחה.
- מתאימים את רמת המאמץ. משימה פשוטה אינה זקוקה תמיד לרמת החשיבה הגבוהה ביותר.
- מחשבים עלות למשימה. סופרים טוקנים, סבבים, הפעלות כלים וזמן עבודה אנושי.
- מפעילים בקרה. בודקים תשובות, הרשאות ותיעוד לפני הרחבת השימוש.
אני חשוב, אבל עדיין, המערכת צריכה להיבחן מול המציאות ולא מול הבטחות. מעולה להתחיל קטן, ללמוד מהר ולהרחיב רק לאחר שמתקבלת תוצאה יציבה.
השוואה בין תרחישי שימוש
| תרחיש | היתרון האפשרי | מה לבדוק |
|---|---|---|
| פיתוח ותחזוקת קוד | הבנת משימות ארוכות ותיקון שורש הבעיה | איכות קוד, בדיקות, אבטחה ותלות בכלים |
| אוטומציה עסקית | חיבור כמה שלבים לתהליך מלא | הרשאות, חריגים ואישור אנושי |
| ניתוח מסמכים ונתונים | עבודה עם טבלאות, בדיקת נאותות וסיכום מידע | דיוק, פרטיות ומקור הנתונים |
| שימוש במחשב | ביצוע פעולות ובדיקת תוצאה חזותית | פעולות בלתי הפיכות ומניעת טעויות |
| מחקר מקצועי | רצף עבודה, בדיקה חוזרת והשוואת שיטות | אימות מומחה והפרדה בין עובדה להשערה |
שאלות נפוצות על
claude opus 5
מהו claude opus 5 ?
claude opus 5 הוא מודל שפה מתקדם של Anthropic. הוא מיועד לקוד, מחקר, אוטומציות, ניתוח מסמכים ומשימות מורכבות.
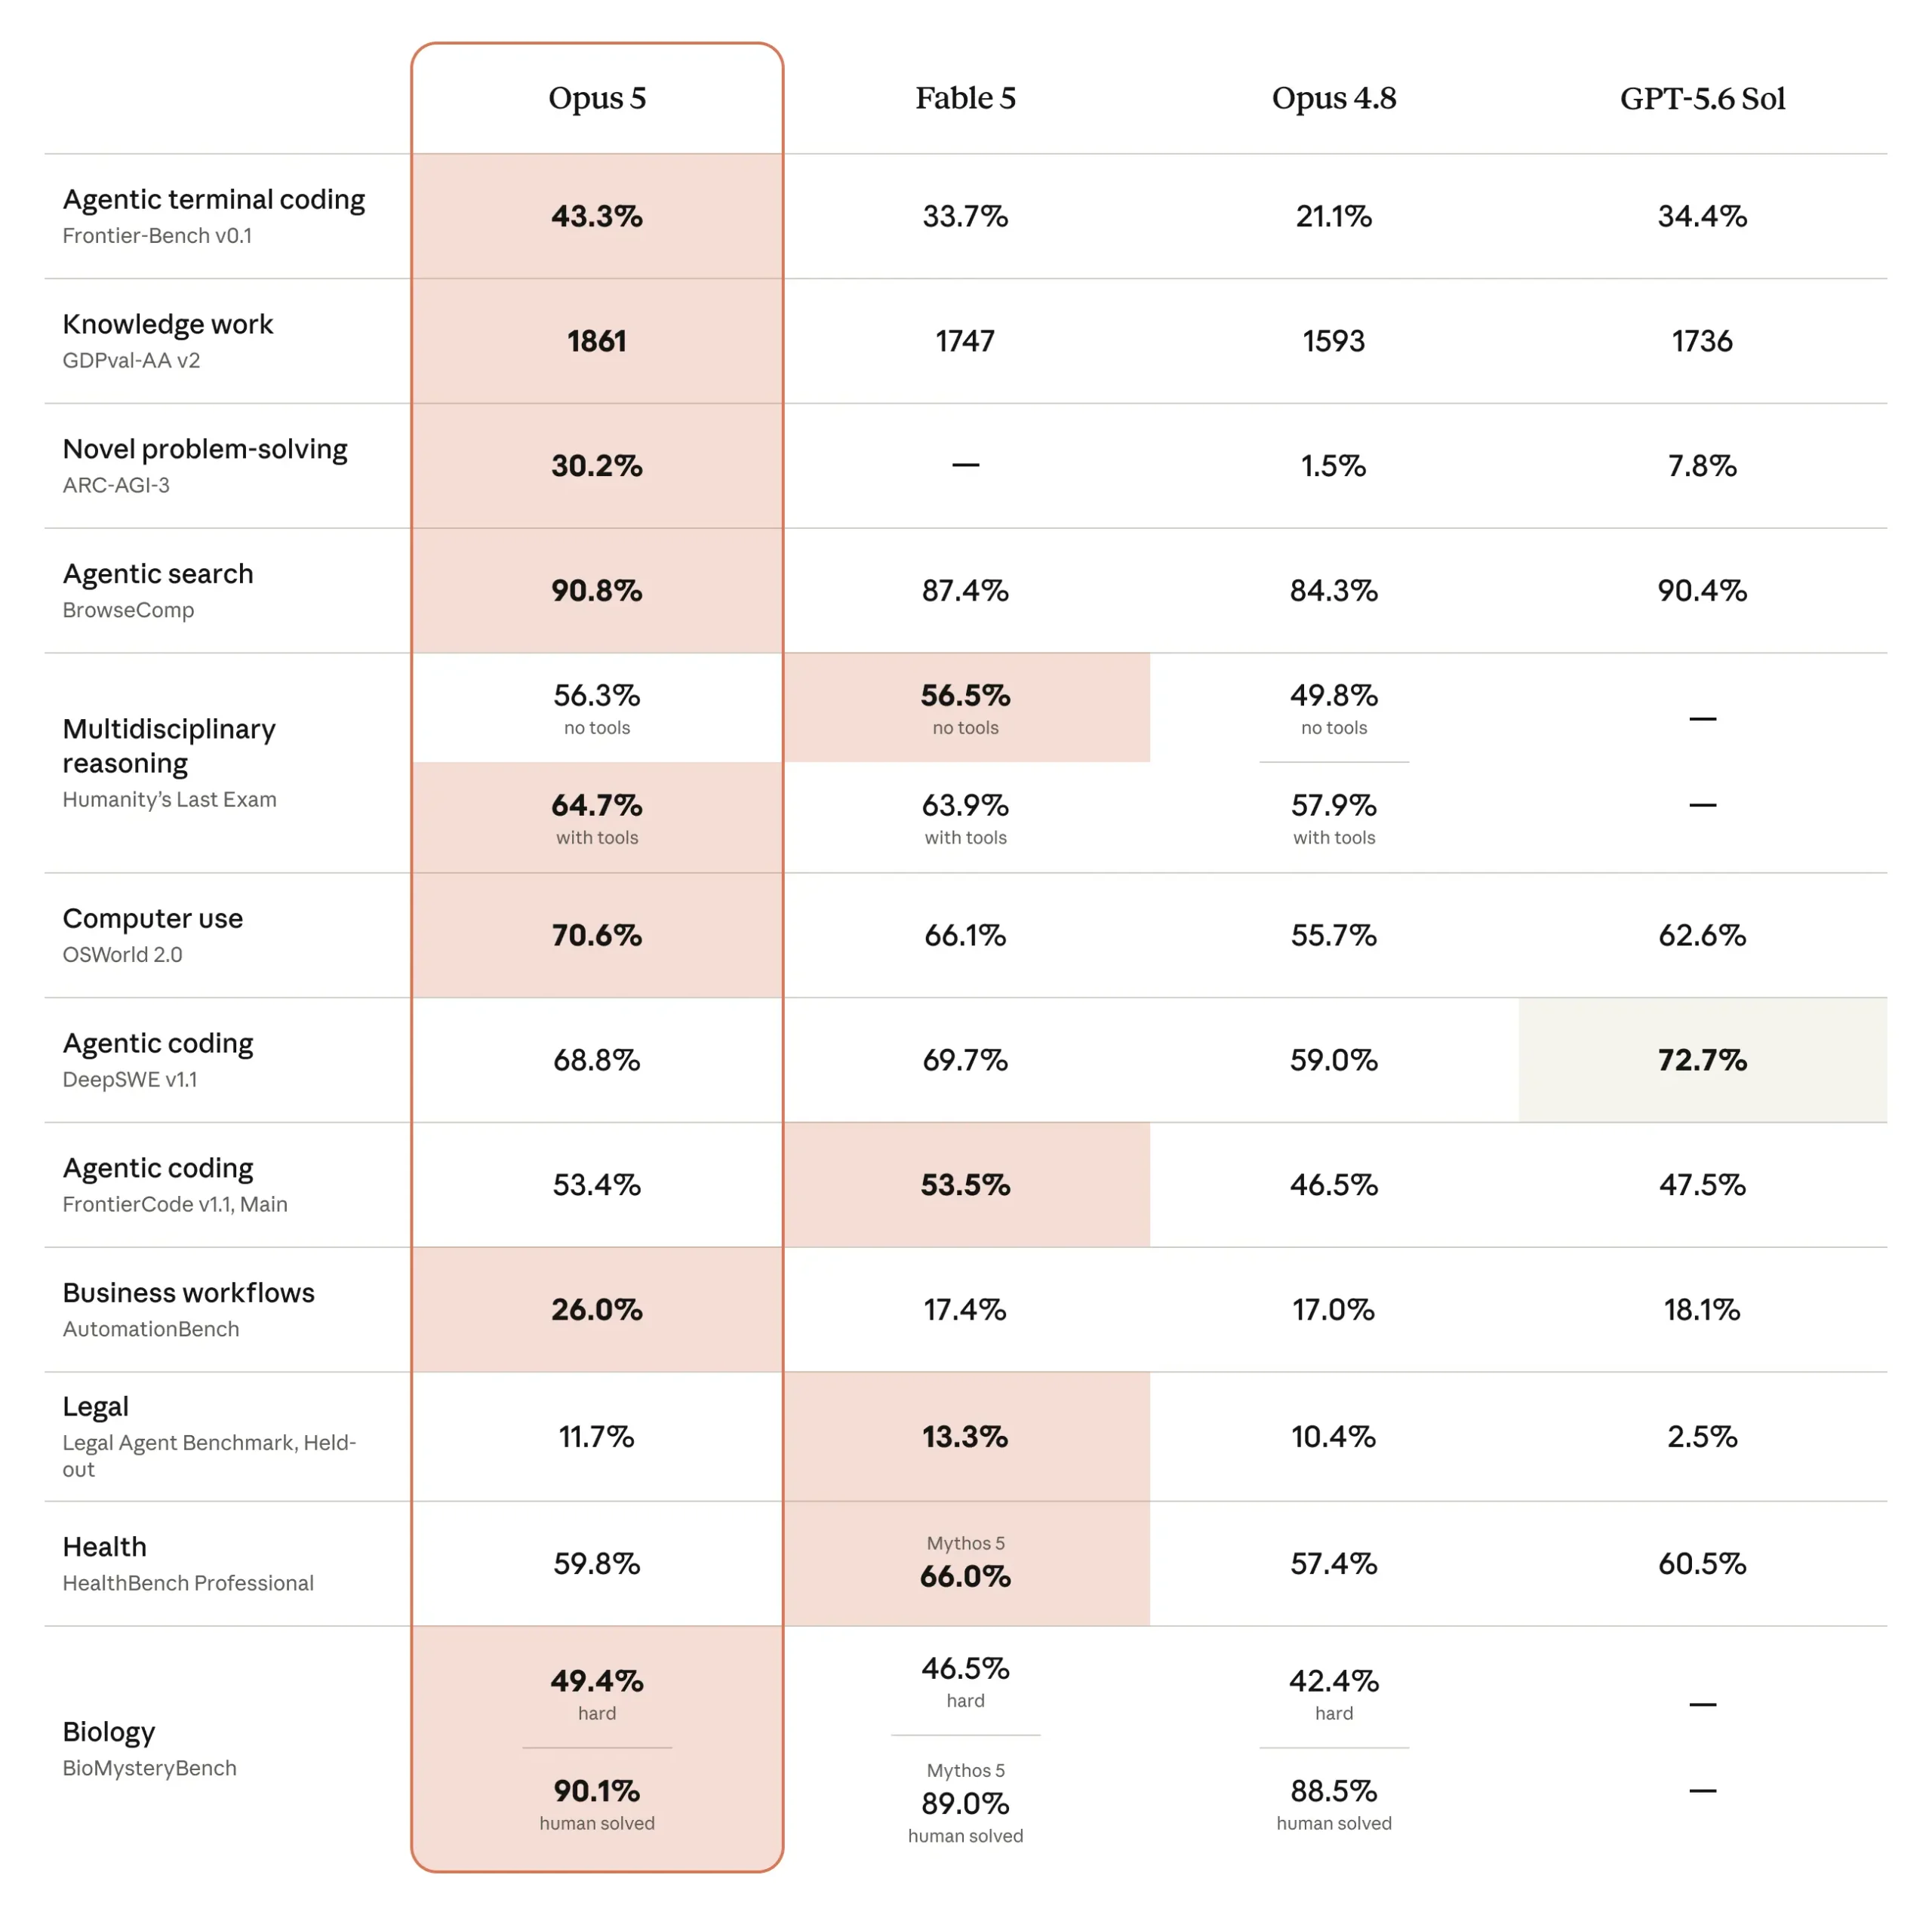
טבלת השוואה בין Opus 5, Fable 5, Opus 4.8 ו‑GPT‑5.6 Sol על פני מדדי ביצוע שונים; רוב הציונים מוצגים באחוזים, למעט Knowledge work, שבו הציון הוא נקודות GDPval‑AA v2. Opus 5 מוביל בין היתר בקידוד טרמינלי (43.3%), פתרון בעיות חדשות (30.2%), חיפוש סוכני (90.8%), שימוש במחשב (70.6%) ו‑AutomationBench (26.0%), בעוד GPT‑5.6 Sol מוביל ב‑DeepSWE עם 72.7% ו‑Fable 5 מוביל ב‑HealthBench עם 66.0%.
האם claude opus 5 טוב יותר מ-Fable 5?
לפי Anthropic, הוא מתקרב ל-Fable 5 ואף מוביל בחלק מהמבחנים. עם זאת, אי אפשר לקבוע שהוא טוב יותר בכל משימה. התוצאות משתנות לפי תחום, רמת מאמץ וכלים.
כמה עולה השימוש במודל?
מחיר הבסיס שפורסם הוא 5 דולר למיליון טוקנים בקלט ו-25 דולר למיליון טוקנים בפלט. מצב Fast עולה פי שניים ממחיר הבסיס. העלות בפועל תלויה באורך המשימה ובמספר הסבבים.
האם המודל מתאים לסוכני AI?
כן. היכולת לשמור על רצף, להשתמש בכלים, לבדוק עבודה ולתקן טעויות הופכת אותו למועמד חזק לסוכנים ארוכי טווח. עדיין צריך להגדיר הרשאות, גבולות ותהליך אישור.
האם אפשר להסתמך עליו ללא בדיקה?
לא. גם מודל מתקדם עלול לטעות או לבצע פעולה לא רצויה. משתמשים בו כמכפיל כוח, לא כתחליף אוטומטי לשיקול דעת מקצועי.
סיכום
claude-opus-5 מציע שילוב מעניין של איכות, יעילות ויכולת פעולה. היתרון המרכזי שלו אינו רק ציוני המבחנים, אלא האפשרות להשלים עבודה מורכבת עם פחות תיקונים ובעלות שמתאימה יותר לעולם העסקי.
אני ממש אוהב את הכיוון הזה, משום שהוא מחזיר את הדיון לתוצאה. מודל מדהים הוא מודל שעוזר לצוות לעבוד טוב יותר, מהר יותר ובאחריות.
בנוסף, חשוב לזכור את המגבלות, לבדוק כל תהליך ולבנות הטמעה מדורגת. אפילו שאני מתרשם מהיכולות, אז המבחן האמיתי נשאר פשוט: האם claude-opus-5 מספק ערך אמיתי בעבודה היומיומית?